CMU15445-lecture11
第十一课:连接算法
1 连接
良好的数据库设计的目标是尽量减少信息重复量。这就是为什么表格是基于规范化理论组成的。因此需要连接来重建原始表格。
本课程将介绍用于合并两个表的内部等值连接算法。等值连接算法连接键相等的表。这些算法可以调整以支持其他连接。
运算符输出
对于在连接属性上匹配的元组 r $\in$ R 和元组 s $\in$ S,连接运算符将 r 和 s 连接在一起形成一个新的输出元组。
实际上,连接运算符生成的输出元组的内容各不相同。这取决于 DBMS 的查询处理模型、存储模型和查询本身。连接运算符输出的内容有多种方法。
- 数据:这种方法将外表和内表中属性的值复制到仅针对该运算符的中间结果表中的元组中。这种方法的优点是查询计划中未来的操作符永远不需要返回基表来获取更多数据。缺点是这需要更多内存来实现整个元组。这称为实例化。DBMS 还可以进行额外的计算并省略查询中以后不需要的属性以进一步优化这种方法。
- 记录ID:在这种方法中,DBMS 仅复制连接键以及匹配元组的记录 ID。这种方法非常适合列存储,因为 DBMS 不会复制查询不需要的数据。这称为延迟实现。
成本分析
这里用于分析不同连接算法的成本指标是用于计算连接的磁盘 I/O 数量。这包括从磁盘读取数据以及将任何中间数据写入磁盘所产生的 I/O。
请注意,只考虑计算连接时的 I/O,而不考虑输出结果时产生的 I/O。这是因为输出成本取决于数据,而且任何连接算法的输出都是相同的,因此不同算法之间的成本不会改变。
本课中使用的变量:
- R表(内表)中有M个页表,共m个元组
- S表(外表)中有N个页表,共n个元组
一般来说,许多算法/优化可以在某些情况下降低连接成本,但没有一种算法可以在所有情况下都运行良好。
2 嵌套循环连接
从高层次上讲,这种类型的连接算法由两个嵌套的 for 循环组成,它们对两个表中的元组进行迭代,并逐对比较它们。如果元组与连接谓词匹配,则输出它们。外层 for 循环中的表称为外表,内层 for 循环中的表称为内表。
DBMS 总是希望使用“较小”的表作为外表。较小可以是元组数量或页面数量。DBMS 还会希望在内存中缓冲尽可能多的外表。它还可以尝试利用索引在内表中查找匹配项。
简单嵌套循环连接
对于外表中的每个元组,将其与内表中的每个元组进行比较。这是最糟糕的情况,DBMS 必须对外表中的每个元组进行整个内表扫描,而没有任何缓存或访问局部性。
复杂度:M + (m * N)
块嵌套循环连接
对于外表中的每个块,从内表获取每个块并比较这两个块中的所有元组。该算法执行的磁盘访问较少,因为 DBMS 扫描内表以查找每个外表块,而不是每个元组。
复杂度:M + (M * N)
如果 DBMS 有 B 个缓冲区可用于计算连接,则它可以使用 B − 2 个缓冲区来扫描外表。它将使用一个缓冲区来扫描内表,另一个缓冲区来存储连接的输出。
复杂度:M + ($\lceil M / (B - 2) \rceil * N$)
索引嵌套循环连接
以前的嵌套循环连接算法性能较差,因为 DBMS 必须执行顺序扫描来检查内表中是否存在匹配项。但是,如果数据库已经为连接键上的其中一个表建立了索引,则可以使用该索引来加快比较速度。DBMS 可以使用现有索引,也可以为连接操作建立临时索引。
外表是没有索引的表,内表是有索引的表。
假设每个索引探测的成本是每个元组的某个常数值 C。
复杂度:M + (m * C)
3 排序合并连接
从高层次上讲,排序合并连接根据连接键对两个表进行排序。DBMS 可以使用外部合并排序算法来实现这一点。然后,它使用游标逐一遍历每个表并发出匹配项(就像合并排序一样)。
如果一个或两个表已经根据连接属性(例如使用聚集索引)排序,或者输出需要根据连接键排序,则此算法很有用。
该算法的最坏情况是两个表中所有元组的连接属性都包含相同的值,这在实际数据库中不太可能发生。在这种情况下,合并的成本将是 M · N。不过,大多数情况下,密钥大多是唯一的,因此合并成本大约为 M + N。
假设 DBMS 有 B 个缓冲区可用于该算法:
- 表R的排序成本:2M * (1 + $\lceil log_{B-1}\lceil M/B \rceil \rceil$)
- 表S的排序成本:2N * (1 + $\lceil log_{B-1}\lceil N/B \rceil \rceil$)
- 合并成本:(M + N)
总成本:排序 + 合并
4 哈希连接
哈希连接算法的高级思想是使用哈希表根据元组的连接属性将其分成更小的块。这减少了 DBMS 计算连接时需要对每个元组执行的比较次数。哈希连接只能用于完整连接键上的等值连接。
如果元组 r $\in$ R 和元组 s $\in$ S 满足连接条件,则它们对于连接属性具有相同的值。如果该值被哈希化为某个值 i,则 R 元组必须在存储桶 ri 中,而 S 元组必须在存储桶 si 中。因此,存储桶 ri 中的 R 元组只需与存储桶 si 中的 S 元组进行比较。
基本哈希连接
- 阶段1 – 构建:首先,扫描外部关系并使用连接属性上的哈希函数 h1 填充哈希表。哈希表中的键是连接属性。值取决于实现(可以是完整元组值或元组 ID)
- 阶段2 - 探测:扫描内部关系并在每个元组的连接属性上使用哈希函数 h1 跳转到哈希表中的相应位置并找到匹配的元组。由于哈希表中可能存在冲突,DBMS 将需要检查连接属性的原始值以确定元组是否真正匹配。
如果 DBMS 知道外表的大小,则连接可以使用静态哈希表。如果不知道大小,则连接必须使用动态哈希表或允许溢出页面。
一个有 N 页的表需要大约 $\sqrt N$ 个缓冲区。上述方法在第 1 阶段创建了最多有 B 个块大小的 B − 1 个溢出分区,因此假设哈希函数均匀分布记录,则可以使用此方法进行哈希处理的最大表是 B · (B − 1) 个缓冲区。如果哈希函数不是均匀的,则可以引入一个模糊因子f>1,因此最大的此类表为$B \sqrt{f N}$。
探测阶段的一个优化是使用布隆过滤器。这是一个概率数据结构,可以放入 CPU 缓存中,并回答问题“密钥 x 是否在哈希表中?”要么肯定否,要么很可能是。这可以通过阻止不会导致发出元组的磁盘读取来减少磁盘 I/O 量。
Grace Hash 连接/分区哈希连接
当表无法放入主内存时,DBMS 必须随机地交换表,这会导致性能不佳。Grace Hash Join 是基本哈希连接的扩展,它还将内表哈希化为写入磁盘的分区。
- 阶段1 – 构建:首先,扫描外表和内表,并使用连接属性上的哈希函数 h1 填充哈希表。哈希表的存储桶根据需要写入磁盘。如果内存中无法容纳单个存储桶,则 DBMS 可以使用不同的哈希函数 h2(其中 h1 ̸= h2)进行递归分区,以进一步划分存储桶。此过程可以递归继续,直到内存中容纳所有存储桶为止。
- 阶段2 - 探测:对于每个存储桶级别,检索外部表和内表的相应页面。然后,对这两个页面中的元组执行嵌套循环连接。页面可以装入内存,因此此连接操作会很快。
分割阶段成本:2 * (M + N)
探测阶段成本:(M + N)
总成本:3 * (M + N)
混合哈希连接优化:在基本哈希连接和 Grace 哈希连接之间进行调整;如果键有偏差,则将热分区保留在内存中并立即进行比较,而不是将其溢出到磁盘。很难正确实施。
5 总结
连接是与关系数据库交互的重要部分,因此确保 DBMS 具有有效的算法来执行连接至关重要。
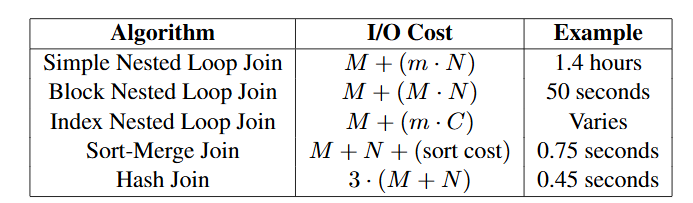
哈希连接几乎总是比基于排序的连接算法更好,但在某些情况下基于排序的连接会更受欢迎。这包括查询非均匀数据、数据已按连接键排序以及结果需要排序的情况。好的 DBMS 会使用其中一种或两种方法。