CMU15445-lecture12
第十二课:查询处理I
1 查询计划
DBMS将一个SQL语句转换成一个查询计划。查询计划中的操作被整理成一个树。数据从这颗树的叶子流向树根。树的根节点的输出是查询的结果。通常情况下,运算符都是二进制的(1-2 个子运算符)。同一个查询计划可以用多种方式执行。
2 处理模型
DBMS 处理模型定义了系统如何执行查询计划。它指定了诸如查询计划的评估方向以及沿途运算符之间传递的数据类型等内容。存在不同的处理模型,它们针对不同的工作负载有各种权衡。
这些模型也可以从上到下或从下到上调用操作符来实现。尽管自上而下的方法更为常见,但自下而上的方法可以更严格地控制管道中的缓存/寄存器。
我们考虑的三种执行模型是:
- 迭代器模型
- 实例化模型
- 矢量化/批处理模型
迭代器模型
迭代器模型,也称为 Volcano 或 Pipeline 模型,是最常见的处理模型,几乎每个(基于行)DBMS 都使用这种模型。
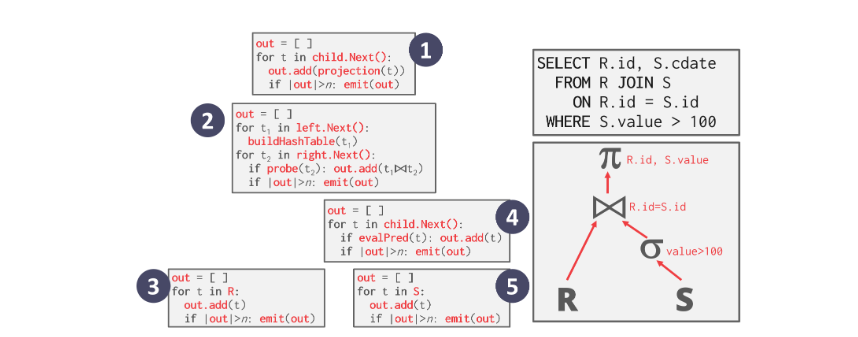
迭代器模型通过为数据库中的每个运算符实现一个 Next 函数来工作。查询计划中的每个节点都会对其子节点调用 Next,直到到达叶节点,叶节点开始向其父节点发出元组进行处理。然后,在检索下一个元组之前,尽可能按照计划处理每个元组。这在基于磁盘的系统中非常有用,因为它允许我们在访问下一个元组或页面之前充分利用内存中的每个元组。图 1 显示了迭代器模型的示例图。
迭代器模型中的查询计划运算符具有高度可组合性,并且易于推理。因为每个运算符都可以独立于查询计划树中的父运算符或子运算符实现,只要它实现如下的 Next 函数:
- 每次调用 Next 时,如果没有更多元组可发出,则运算符将返回单个元组或空标记。
- 该运算符实现一个循环,调用其子运算符上的 Next 来检索它们的元组,然后处理它们。这样,对父节点调用 Next 就会对其子节点调用 Next。作为响应,子节点将返回父节点必须处理的下一个元组。
迭代器模型允许流水线操作,其中 DBMS 可以通过尽可能多的运算符处理一个元组,然后再检索下一个元组。查询计划中针对给定元组执行的一系列任务称为管道。
某些运算符会阻塞,直到子运算符发出所有元组。此类运算符的示例包括连接、子查询和排序 (ORDER BY)。此类运算符称为管道断路器。
输出控制可以通过这种方法(LIMIT)轻松地工作,因为一旦操作员拥有了所需的所有元组,它就可以停止在其子操作员上调用 Next。

实例化模型
实例化模型是迭代器模型的一种特殊化,其中每个运算符一次处理其输入,然后一次发出其输出。每个运算符每次到达时都会返回其所有元组,而不是使用返回单个元组的下一个函数。为了避免扫描太多元组,DBMS 可以将需要多少元组的信息传播给后续操作符(例如 LIMIT)。运算符将其输出“实例化”为单个结果。输出可以是整个元组 (NSM) 或列的子集 (DSM)。图 2 显示了实例化模型的示意图。
每个查询计划运算符都实现一个Output函数:
- 操作立即处理子节点传来的所有元组
- 此函数的返回结果是该运算符将发出的所有元组。当该运算符完成执行时,DBMS 无需返回该函数来检索更多数据。
这种方法更适合OLTP工作负载,因为查询通常一次只访问少量元组。因此,检索元组的函数调用较少。实例化模型不适合具有大量中间结果的 OLAP 查询,因为 DBMS 可能必须在操作员之间将这些结果溢出到磁盘。

矢量化模型
与迭代器模型一样,矢量化模型中的每个运算符都实现一个 Next 函数。但是,每个运算符都会发出一批数据(即向量),而不是单个元组。运算符的内循环实现针对处理批量数据(而不是一次处理单个数据)进行了优化。批次的大小可能因硬件或查询属性而异。请参阅图 3 中的矢量化模型示例。
矢量化模型方法非常适合需要扫描大量元组的 OLAP 查询,因为 Next 函数的调用次数较少。
矢量化模型使得操作能够更轻松地使用矢量化(SIMD)指令来处理批量元组。
操作方向
- 方式一:自顶向下
- 从根开始,将数据从子节点“拉”到父节点
- 元组总是通过函数调用传输
- 方式二:自底向上
- 从叶节点开始,将数据从子节点“推送”到父节点
- 允许更严格地控制操作管道中的缓存/寄存器
3 访问方法
访问方法是 DBMS 访问表中存储的数据的方式。一般来说,访问模型有两种方法:要么从表中读取数据,要么通过顺序扫描从索引中读取数据。
顺序扫描
顺序扫描运算符遍历表中的每个页面并从缓冲池中检索它。当扫描遍历每个页面上的所有元组时,它会评估谓词以决定是否将元组发送给下一个运算符。
DBMS 维护一个内部游标,用于跟踪其检查的最后一页/槽。
顺序表扫描几乎始终是 DBMS 执行查询时效率最低的方法。有许多优化方法可帮助加快顺序扫描速度:
- 预读取:提前获取接下来的几页,以便 DBMS 在访问每个页面时不必阻塞存储 I/O。
- 缓存池绕过:扫描操作符将从磁盘获取的页面存储在其本地内存中而不是缓冲池中,以避免顺序洪泛。
- 并行化:使用多个线程/进程并行执行扫描。
- 慢实例化:DBMS 可以将元组的拼接延迟到查询计划的上部。这样每个操作符都可以将所需的最少信息传递给下一个操作符(例如记录 ID、列中记录的偏移量)。这仅在列存储系统中有用。
- 堆聚类:元组按照聚类索引指定的顺序存储在堆页中。
- 近似查询(跳过有损数据):对整个表的抽样子集执行查询以产生近似结果。这通常用于在允许低误差产生近乎准确的答案的场景中计算聚合。
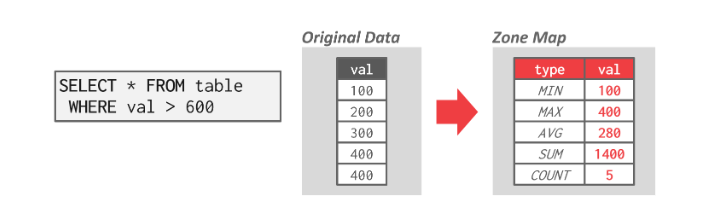
- 区域图(无损数据跳过):预先计算页面中每个元组属性的聚合。然后,DBMS 可以通过首先检查区域图来决定是否需要访问页面。每个页面的区域图存储在单独的页面中,并且每个区域图页面中通常有多个条目。因此,可以减少连续扫描中检查的总页面数。区域图在云数据库系统中尤其有价值,因为通过网络传输数据会产生更大的成本。参见图 4 的区域地图示例。
索引扫描
在索引扫描中,DBMS 选择一个索引来查找查询所需的元组。
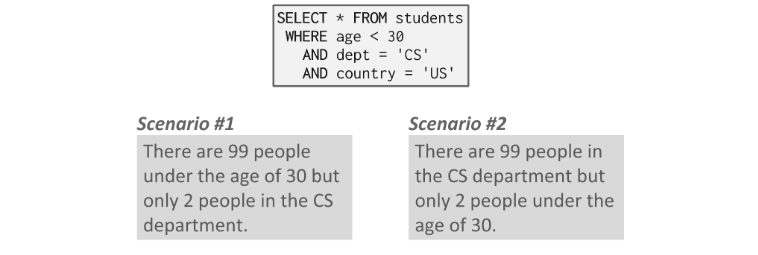
DBMS 的索引选择过程涉及许多因素,包括:
- 索引包含哪些属性
- 查询引用了哪些属性
- 属性的值域
- 谓词组合
- 索引是否具有唯一键或非唯一键
图 5 显示了索引扫描的一个简单示例。
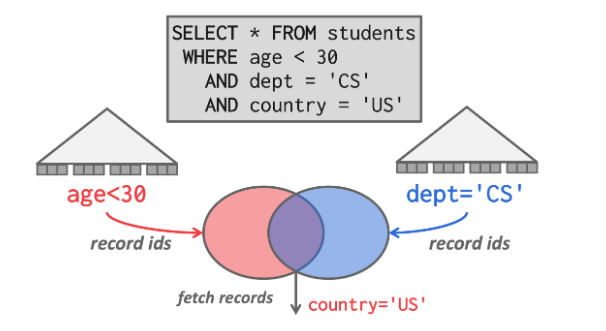
更高级的 DBMS 支持多索引扫描。当对查询使用多个索引时,DBMS 会使用每个匹配的索引计算记录 ID 集,根据查询的谓词组合这些集合,然后检索记录并应用可能保留的任何谓词。DBMS 可以使用位图、哈希表或布隆过滤器通过集合交集计算记录 ID。请参阅图 6 中利用多索引扫描的示例。
4 修改查询
修改数据库(INSERT、UPDATE、DELETE)的操作员负责检查约束和更新索引。对于UPDATE/DELETE,子操作符传递目标元组的记录ID,并且必须跟踪先前看到的元组。
关于如何处理 INSERT 运算符有两种实现选择:
- 选择1:在运算符内部实现元组。
- 选择2:运算符插入从子运算符传入的任何元组。
万圣节问题
万圣节问题是一种异常现象,其中更新操作会更改元组的物理位置,从而导致扫描运算符多次访问该元组。这可能发生在聚簇表或索引扫描上。
这一现象最初是由 IBM 研究人员在 1976 年万圣节当天构建 System R 时发现的。解决此问题的方法是跟踪每个查询的修改记录 ID。
5 表达式求值
DBMS 将 WHERE 子句表示为表达式树(参见图 7 中的示例)。树中的节点表示不同的表达式类型。
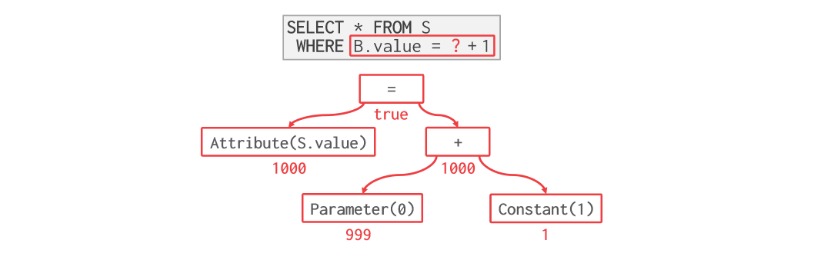
可以存储在树节点中的表达式类型的一些示例:
- 比较(=、<、>、!=)
- 连接 (AND)、分离 (OR)
- 算术运算符(+、-、*、/、%)
- 常量和参数值
- 元组属性引用
为了在运行时评估表达式树,DBMS 维护一个上下文句柄,其中包含执行的元数据,例如当前元组、参数和表架构。然后,DBMS 遍历树来评估其运算符并产生结果。
以这种方式评估谓词很慢,因为 DBMS 必须遍历整个树并确定每个运算符要采取的正确操作。更好的方法是直接评估表达式(想想 JIT 编译)。基于内部成本模型,DBMS 将确定是否采用代码生成来加速查询。