CMU15445-lecture13
第十三课:查询处理II
1 背景
前面关于查询执行的讨论都假设查询由单个工作器(即线程)执行。然而,在实践中,查询通常由多个工作器并行执行。
并行执行为 DBMS 提供了许多关键优势:
- 提高吞吐量(每秒更多查询)和延迟(每个查询所用时间更少)的性能。
- 从 DBMS 外部客户端的角度来看,响应能力和可用性有所提高。
- 潜在降低总拥有成本 (TCO)。此成本包括硬件采购和软件许可,以及部署 DBMS 的人工开销和运行机器所需的能源。
DBMS 支持两种类型的并行性:查询间并行性和查询内并行性。
2 并行vs分布式数据库
在并行和分布式系统中,数据库分布在多个“资源”上以提高并行性。这些资源可能是计算资源(例如,CPU 内核、CPU 插槽、GPU、附加机器)或存储资源(例如,磁盘、内存)。
区分并行和分布式系统非常重要。
- 并行DBMS 在并行 DBMS 中,资源或节点在物理上彼此接近。这些节点通过高速互连进行通信。假设资源之间的通信不仅快速,而且廉价可靠。
- 分布式DBMS 在分布式 DBMS 中,资源可能彼此相距甚远;这可能意味着数据库跨越世界不同地区的机架或数据中心。因此,资源通过公共网络进行通信时,互连速度较慢,节点之间的通信成本较高,故障不容忽视。
即使数据库可能在物理上分布在多个资源上,但它在应用程序看来仍然是一个逻辑数据库实例。因此,针对单节点 DBMS 执行的 SQL 查询应该在并行或分布式 DBMS 上生成相同的结果。
3 处理模型
DBMS 进程模型定义系统如何支持来自多用户应用程序/环境的并发请求。DBMS 由多个工作器组成,负责代表客户端执行任务并返回结果。应用程序可能会同时发送一个或多个大型请求,这些请求必须分配给不同的工作程序。
DBMS 可能采用两种主要进程模型:每个工作者进程和每个工作者线程。第三种常见的数据库使用模式采用嵌入式方法。
每个工作者进程
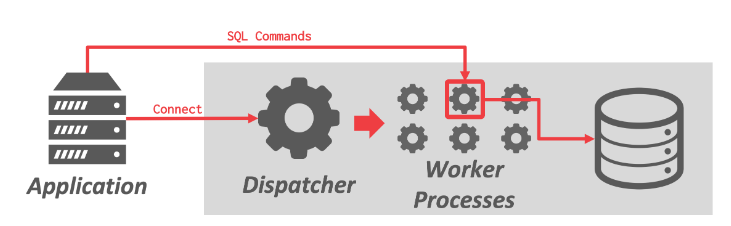
最基本的方法是每个工作进程。在这里,每个工作进程都是一个单独的操作系统进程,因此依赖于操作系统调度程序。应用程序发送请求并打开与数据库系统的连接。一些调度程序接收请求,选择其中一个工作进程来管理连接。应用程序现在直接与负责执行查询请求的工作进程进行通信。此事件序列如图 1 所示。
依赖操作系统进行调度会有效降低 DBMS 对执行的控制力。此外,该模型依赖共享内存来维护全局数据结构或依赖消息传递,开销较高。
每个工作进程方法的优点在于进程崩溃不会破坏整个系统,因为每个工作进程都在其自己的操作系统进程上下文中运行。
这个过程模型提出了多个在不同进程中工作的工人制作同一页面多个副本的问题。一个最大化内存使用的解决方案是使用共享内存来存储全局数据结构,以便不同进程中的工人可以共享这些数据。
采用每个工作进程模型的系统示例包括 IBM DB2、Postgres 和 Oracle。当这些 DBMS 被开发时,pthreads 尚未成为标准线程模型。线程的语义因操作系统而异,而 fork() 的定义更为明确。
每个工作者线程
如今最常见的模型是每个工作线程一个线程。不同于让不同的进程执行不同的任务,每个数据库系统只有一个进程和多个工作线程。在这种环境中,数据库管理系统(DBMS)对任务和线程具有完全的控制权,可以管理自己的调度。多线程模型可能使用或不使用分发线程。线程每个工作的模型示意图如图 2 所示。
使用多线程架构提供了一定的优势。首先,每次上下文切换的开销较小。此外,不必维护共享模型。然而,每个工作线程的模型并不一定意味着数据库管理系统支持查询内部的并行性。
在过去20年中几乎所有创建的数据库管理系统都采用这种方法,包括Microsoft SQL Server和MySQL。IBM DB2和Oracle也更新了他们的模型,以支持这种方法。Postgres和Postgres衍生的数据库在很大程度上仍然使用基于进程的方法。
调度
总之,对于每个查询计划,DBMS 必须决定在何处、何时以及如何执行。相关问题包括:
- 应该使用多少个任务?
- 应该使用多少个CPU核心?
- 这些任务应该在哪些 CPU 核心上执行?
- 任务应该将其输出存储在哪里?
在制定有关查询计划的决策时,DBMS 总是比 OS 了解得更多,因此应该优先考虑。
嵌入式DBMS
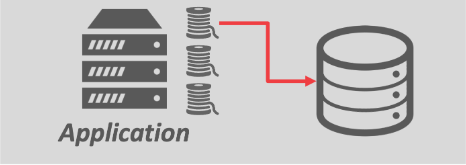
一种非常不同的数据库使用模式涉及将系统在应用程序的相同地址空间中运行,与数据库独立于应用程序的客户端-服务器模型相对。在这种情况下,应用程序将设置线程和任务以在数据库系统上运行。应用程序本身在很大程度上将负责调度。嵌入式数据库管理系统的调度行为的示意图如图3所示。
DuckDB、SQLite和RocksDB是最著名的嵌入式数据库管理系统。
4 查询间并行
在查询间并行中,DBMS 会同时执行不同的查询。由于多个工作器同时运行请求,因此整体性能得到改善。这会增加吞吐量并减少延迟。
如果查询是只读的,则查询之间几乎不需要协调。但是,如果多个查询同时更新数据库,则会出现更复杂的冲突。这些问题将在第 15 讲中进一步讨论。
5 查询内并行
在查询内并行中,DBMS 并行执行单个查询的操作。这减少了长时间运行的查询的延迟。
查询内并行性的组织可以从生产者/消费者范式的角度来思考。每个操作符都是数据的生产者,同时也是其下层运行的操作符的数据的消费者。
每个关系运算符都有并行算法。DBMS 既可以让多个线程访问集中式数据结构,也可以使用分区来划分工作。
在查询内并行性中,有三种类型的并行性:操作内并行性、操作间并行性和密集并行性。这些方法并不相互排斥。DBMS 有责任将这些技术结合起来,以优化给定工作负载的性能。
操作内并行性(水平)
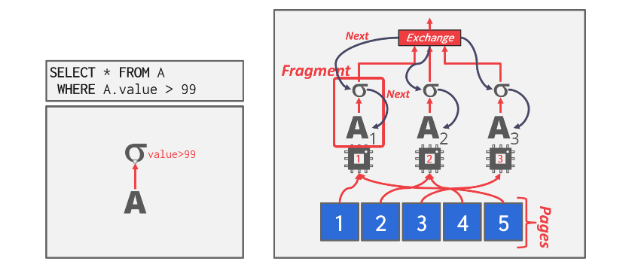
在操作符内并行中,查询计划的操作符被分解为独立的片段,这些片段对不同的(不相交的)数据子集执行相同的功能。
DBMS 在查询计划中插入一个交换运算符,以合并子运算符的结果。交换运算符会阻止 DBMS 在计划中执行其上方的运算符,直到它收到来自子运算符的所有数据。图4中展示了一个样例。
一般来说,交换操作有三种类型:
- 聚集:将多个worker中的结果聚合成单个输出流。这是并行 DBMS 中最常用的类型。
- 分发:将单个输入流分成多个输出流。
- 重新分区:在多个输出流中重新组织多个输入流。这允许 DBMS 接收以一种方式分区的输入,然后以另一种方式重新分配它们。
操作间并行性(垂直)
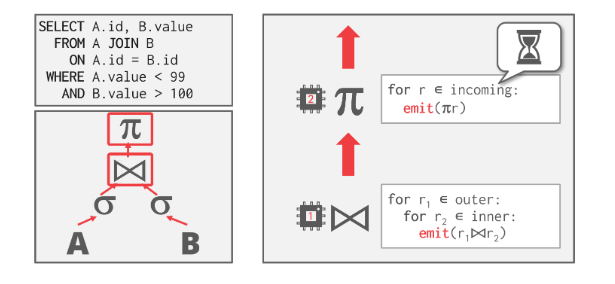
在运算符间并行中,DBMS 重叠运算符,以便将数据从一个阶段流水线传输到下一个阶段而无需具体化。这有时称为流水线并行。参见图 5 中的示例。
这种方法广泛应用于流处理系统,即对输入元组流持续执行查询的系统。
密集并行性
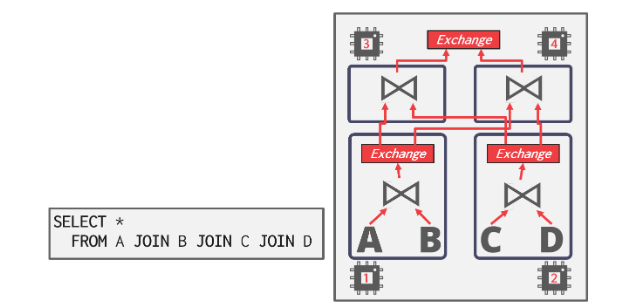
密集并行是操作符内并行和操作符间并行的混合,其中工作者同时执行来自查询计划的不同段的多个操作符。
DBMS 仍然使用交换运算符来组合这些段的中间结果。示例如图 6 所示。
6 I/O并行
如果磁盘始终是主要瓶颈,那么使用额外的进程/线程来并行执行查询不会提高性能。因此,能够将数据库拆分到多个存储设备中非常重要。
为了解决这个问题,DBMS 使用 I/O 并行性将安装拆分到多个设备上。I/O 并行性的两种方法是多磁盘并行性和数据库分区。
多磁盘并行
在多磁盘并行中,操作系统/硬件配置为将 DBMS 的文件存储在多个存储设备上。这可以通过存储设备或 RAID 配置来实现。所有存储设置对 DBMS 都是透明的,因此工作人员无法在不同的设备上运行,因为 DBMS 不知道底层的并行性。
数据库分区
在数据库分区中,数据库被分成不相交的子集,可以分配给离散磁盘。一些 DBMS 允许指定每个单独数据库的磁盘位置。如果 DBMS 将每个数据库存储在单独的目录中,则在文件系统级别上很容易做到这一点。更改的日志文件通常是共享的。
逻辑分区的想法是将单个逻辑表分成不相交的物理段,并单独存储/管理。理想情况下,这种分区对于应用程序来说是透明的。也就是说,应用程序应该能够访问逻辑表,而不必关心内容是如何存储的。
分区有两种方法:垂直分区和水平分区。
在垂直分区中,表的属性存储在单独的位置(如列存储)。必须存储元组信息才能重建原始记录。
在水平分区中,表的元组会根据一些分区键划分为不相交的段。有多种方法可以决定如何分区(例如哈希、范围或谓词分区)。每种方法的有效性取决于查询。
我们将在本学期晚些时候讨论分布式数据库时介绍这些方法。