14th-March
To-do List
[x] 算法
- [x] 链表和分治
[ ] 项目
- [x] cmu15445
- [ ] mit6.824
- [ ] mit6.081
[ ] 八股
- [x] 操作系统
- [x] 计算机网络
- [ ] 数据库
- [ ] redis
- [x] 日常总结
算法
今天主要是分治和链表的操作的结合,虽然没有什么很难的知识点,但却是是难了很多
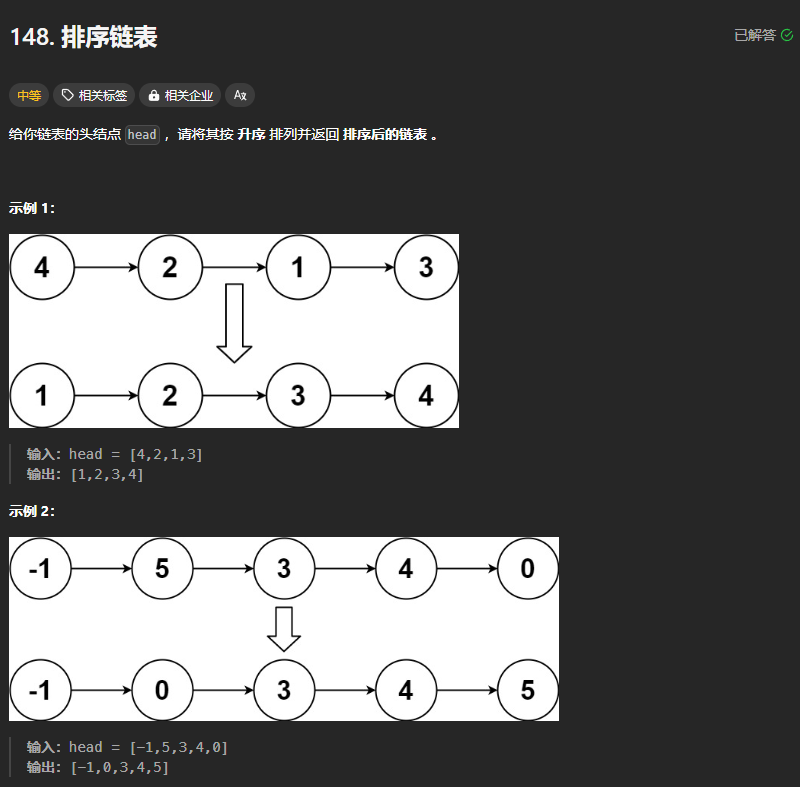
1.排序链表
题面:
题解:
还记得合并两个有序链表,,,所以可以找到链表的中点,将链表拆成两个子链表(!快慢指针找中点),然后对两个子链表分别排序,最后再合并
1 | |
2.环形子数组的最大和
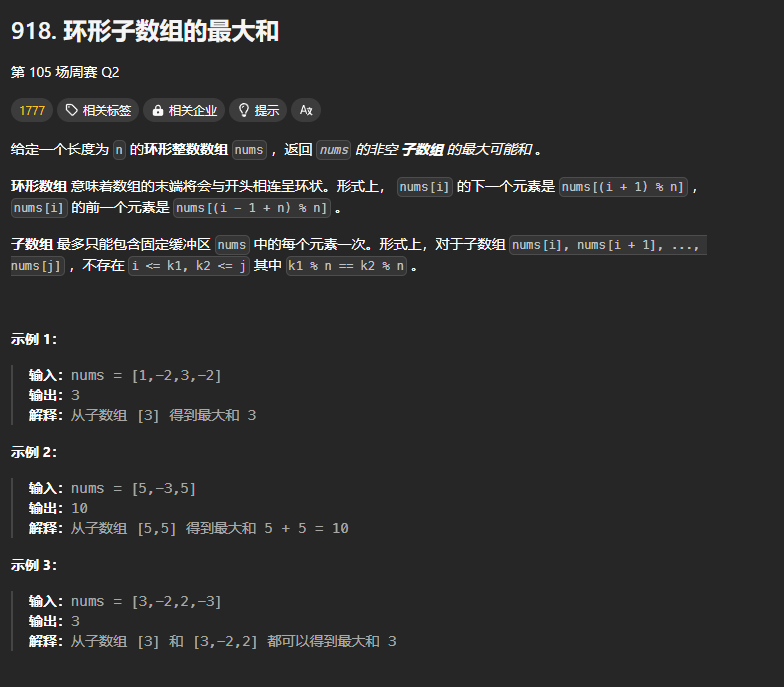
题解:
。。。明明说有什么Kadane算法,但是确实一点都没看到 还是普通的滑窗感觉(抄的官解,懒得写了主要是)
1 | |
项目
今天主要是过了一边mapreduce,花了一下午。。。
中午主要把445的p3 task1解决了
seqscan insert delete indexscan
八股
计算机网络
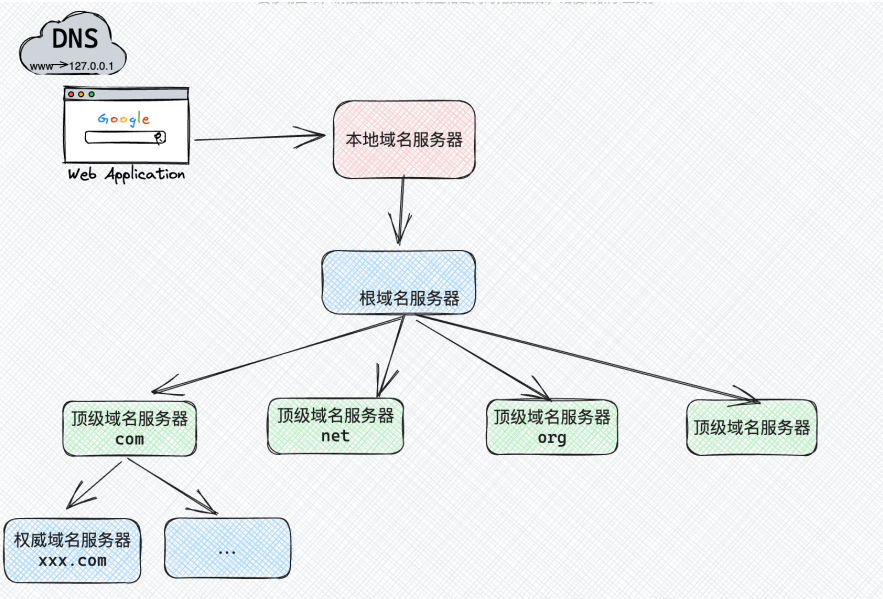
DNS解析过程
- 先查询浏览器缓存是否有该域名对应的IP地址。
- 如果浏览器缓存中没有,会去计算机本地的Host文件中查询是否有对应的缓存。
- 如果Host文件中也没有则会向本地的DNS服务器发起一个DNS查询请求。
- 如果本地DNS解析器有该域名的IP地址,就会直接返回,进入过没有缓存该域名的解析记录,它会向根DNS服务器发出查询请求。根DNS服务器并不负责解析域名,但它能告诉本地DNS解析器应该向哪个顶级域名的DNS服务器继续查询。
- 本地DNS解析器接着向指定的顶级域名DNS服务器发出查询请求。权威DNS服务器是负责存储特定域名和IP地址映射的服务器。当权威DNS服务器收到查询请求时,它会查找”example.com“域名对应的IP地址,并将结果返回给本地DNS解析器。
- 本地DNS解析器将收到的IP地址返回给浏览器,并且还会将域名解析结果缓存在本地,以便下次访问时更快地相应。
- 浏览器发起连接:本地DNS解析器已经将IP地址返回给您的计算机,您的浏览器可以使用该IP地址与目标服务器建立连接,开始获取网页内容。
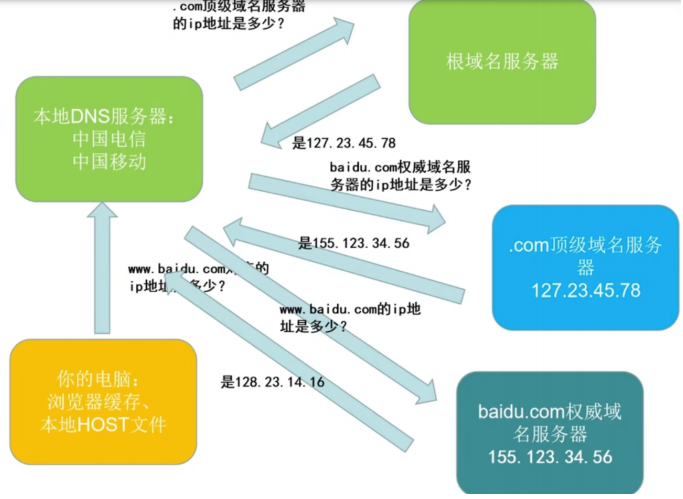
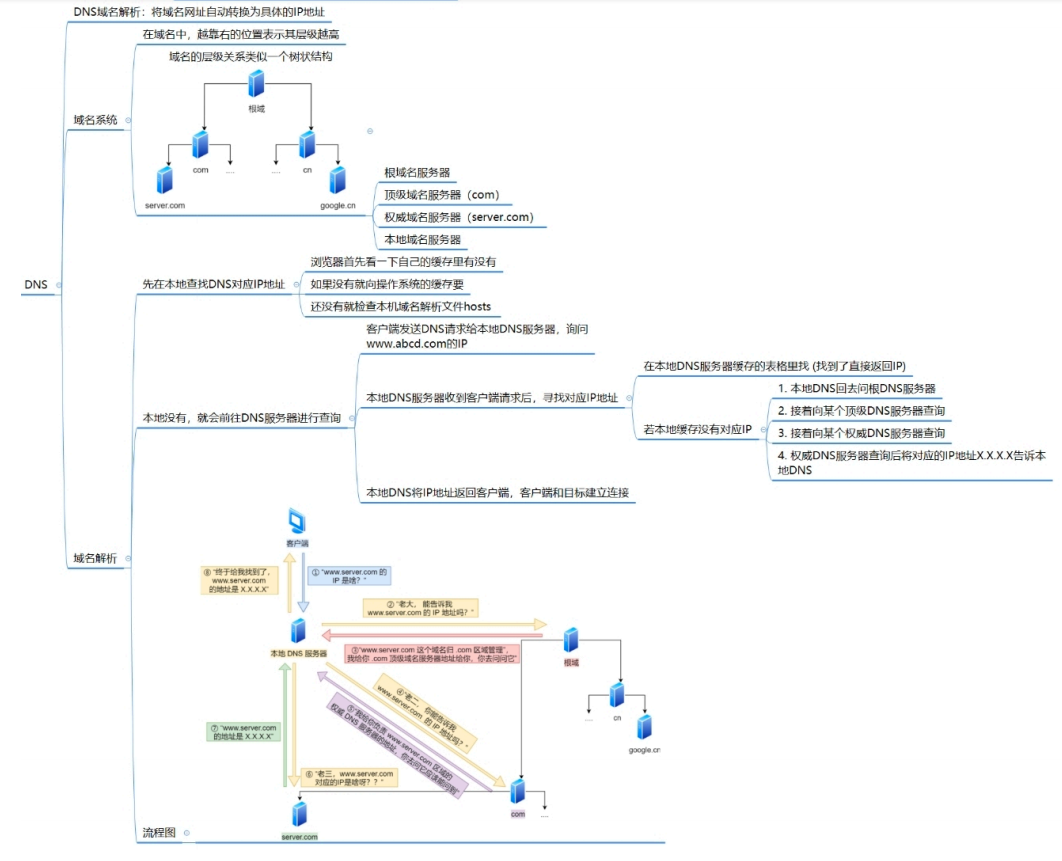
递归查询和迭代查询
(1)递归查询
在递归查询中,DNS客户端向上层DNS服务器发起查询请求,并要求这些服务器直接提供完整的解析结果。递归查询的特点是,DNS客户端只需要发送一个查询请求,然后等待完整的解析结果。上层DNS服务器会自行查询下一级的服务器,并将最终结果返回给DNS客户端。
(2)迭代查询
在迭代查询中,DNS客户端向上层DNS服务器发起查询请求,但不要求直接提供完整的解析结果。相反,DNS客户端只是询问上层服务器⼀个更⾼级的域名服务器的地址,然后再⾃⾏向那个更⾼级的服务器发起查询请求,以此类推,直到获取完整的解析结果为⽌。
递归查询适合普通⽤户和客户端,⽽迭代查询适⽤于DNS服务器之间的通信。
操作系统
调度算法
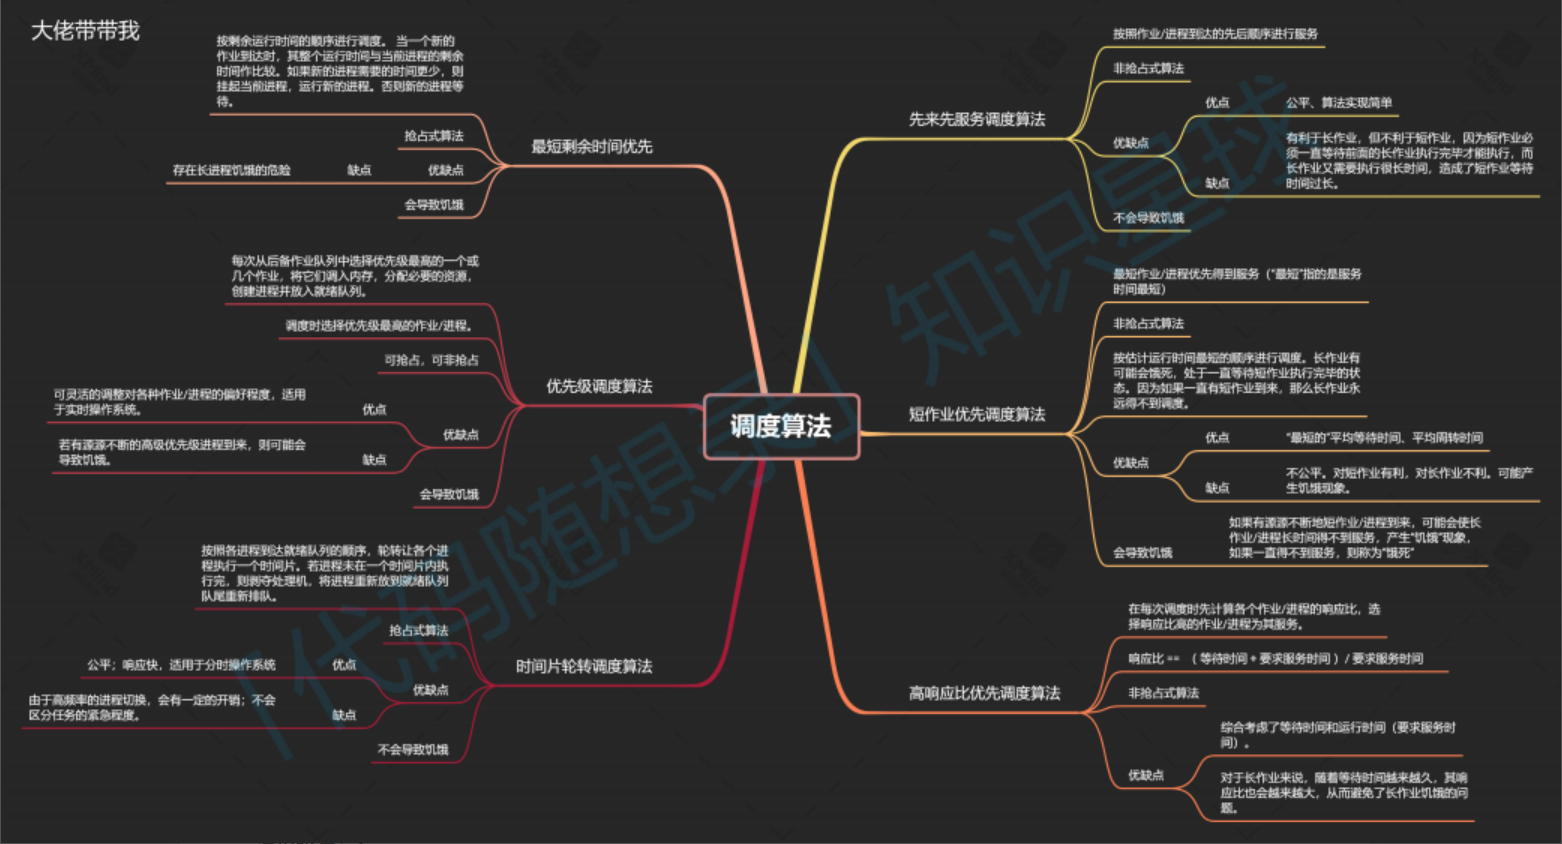
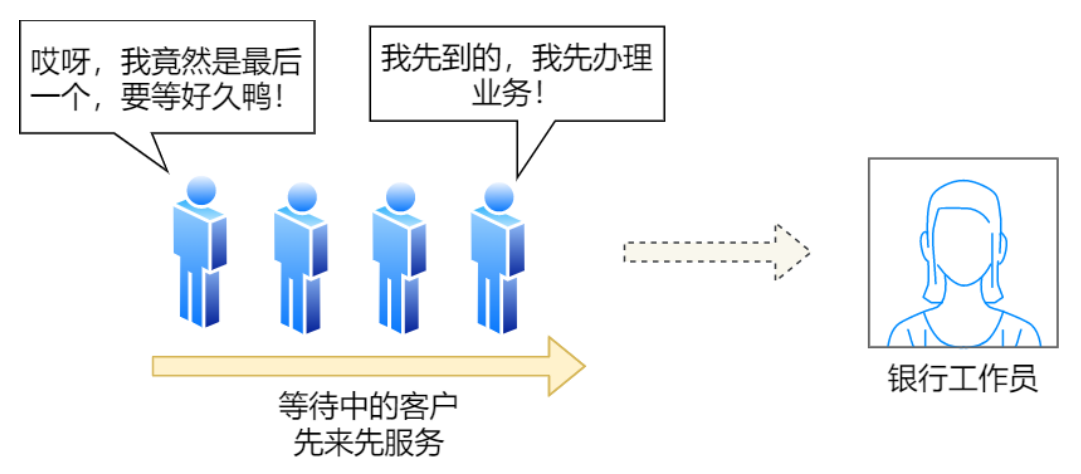
(1)先来先服务(FCFS)
每次从就绪队列选择最先进入队列的进程,然后一直运行,知道进程退出或被阻塞,才会继续从队列中选择第一个进程接着运行。
这种算法虽然看上去公平,但是如果有一个长作业需要处理,后面的短作业需要处理很长时间。
先来先服务的特点是算法简单,对长作业比较有利,对短作业不利,适用于CPU繁忙型的系统,而不适用于I/O繁忙型作业的系统。
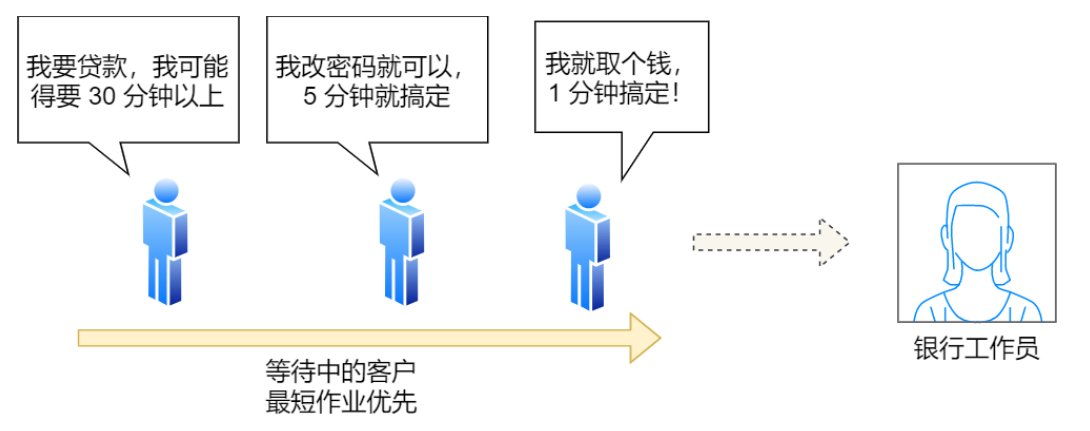
(2)最短作业优先(SJF)
最短作业优先调度算法从就绪队列中选择一个估计运行时间最短的作业,将之调入到内存中运行,这有利于提高系统的吞吐量。
但是这对长作业十分不利,由于调度程序总是优先调度短作业,将会导致长作业长期不被调度,此外该算法也没有考虑到作业的紧迫程度,因此不能保证紧迫性作业会被及时处理。
(3)高响应比优先调度算法
每次进行进程调度时,先计算响应比优先级,然后把响应比优先级最高的进程投入运行
根据公式可以知道
- 作业的等待时间相同时,如果要求服务时间越短,则响应比更高,有利于短作业执行
- 当要求服务时间相同时,响应比由等待时间决定,如果等待时间越长,则响应比越高
- 对于长作业,作业的响应比可以随着等待时间的增加而提高
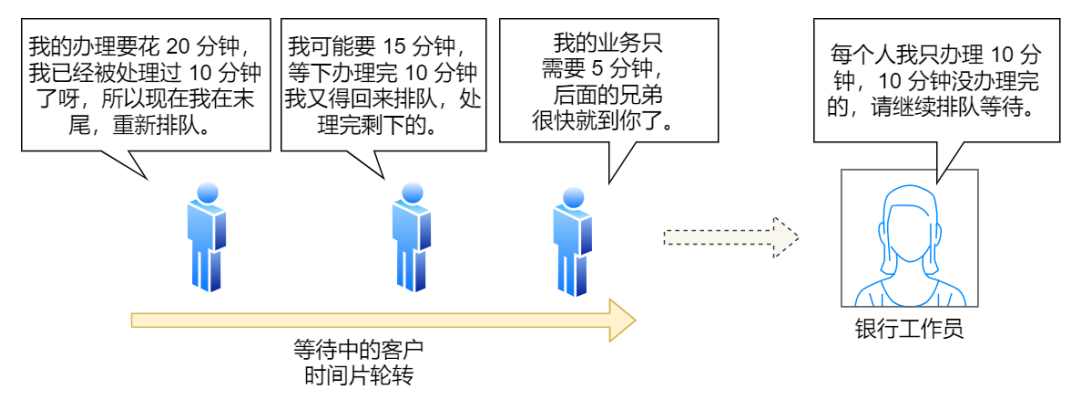
(4)时间片轮转调度算法
每个进程被分配⼀个时间段,称为时间⽚(Quantum),即允许该进程在该时间段中运⾏。
- 如果时间⽚⽤完,进程还在运⾏,那么将会把此进程从 CPU 释放出来,并把 CPU 分配给另外⼀个进程;
- 如果该进程在时间⽚结束前阻塞或结束,则 CPU立即进⾏切换;
另外,时间⽚的⻓度就是⼀个很关键的点:
- 如果时间片设的太短会导致过多的进程上下文切换,降低了CPU效率;
- 如果设的太长又可能引起对短作业进程的响应时间变长。
一般来说,时间片设为20~50ms通常是一个比较合理的折中值。
(5)最高优先级调度算法
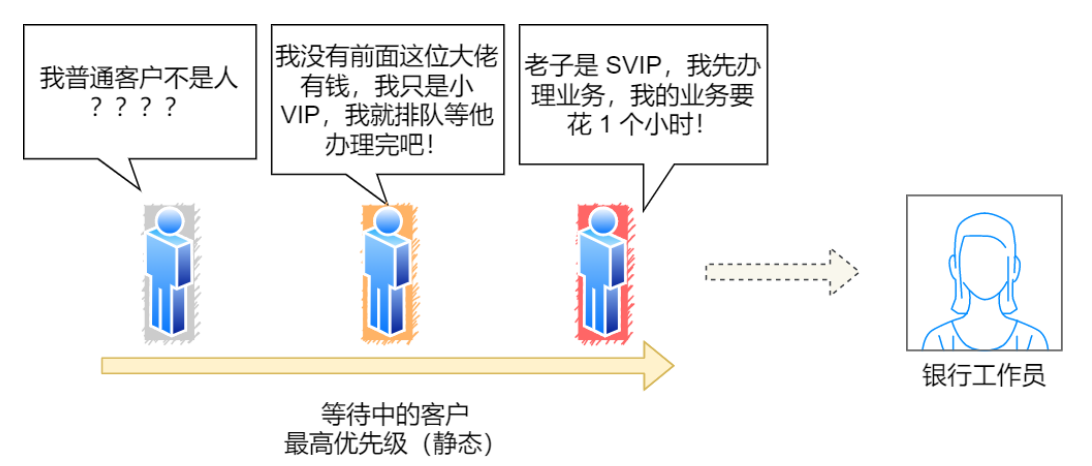
从就绪队列中选择最高优先级的进程进行运行,但进程的优先级可以分为静态优先级和动态优先级
- 静态优先级:优先级在创建进程时已经确定,在进程运行期间保持不变,确定静态优先级的主要依据又进程类型,对资源的要求,用户要求。
- 动态优先级:进程运行过程中,根据进程运行时间和等待时间等因素调整进程的优先级
但这种算法可能会导致低优先级的进程永远不被执行
(6)多级队列调度算法
上⾯的各种调度算法是固定且单⼀的,⽆法满⾜系统中不同⽤户对进程调度策略的不同要求,多级队列调度算法在系统中设置多个就绪队列,将不同类型或性质的进程固定分配到不同的就绪队列,每个队列可以实施不同的调度算法。
(7)多级反馈队列调度算法
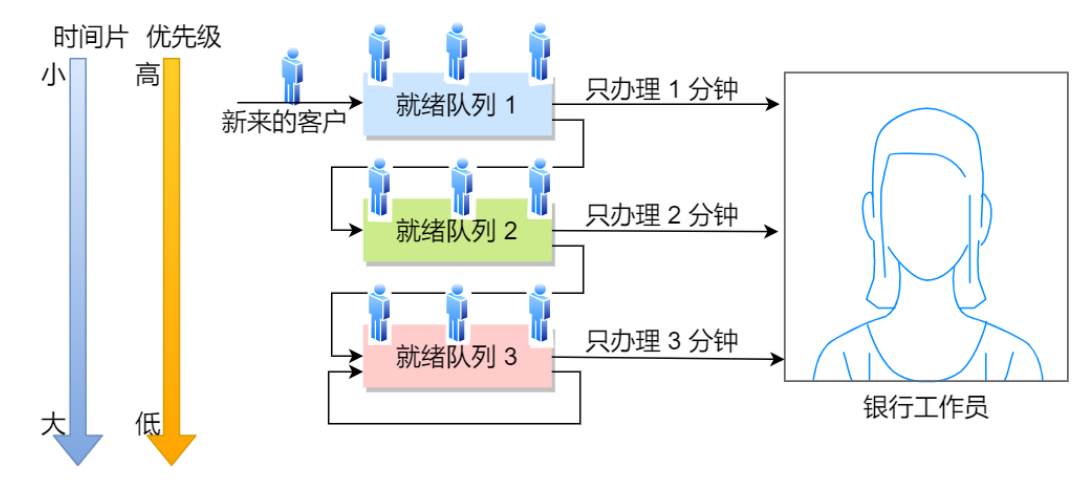
多级反馈队列调度算法融合了时间⽚轮转调度算法和优先级调度算法,通过动态调整进程的优先级和时间⽚⼤⼩,多级反馈队列调度算法可以兼顾多⽅⾯的系统⽬标
多级反馈队列调度算法的实现思想如下:
- 设置多个就绪队列,并为每个队列赋予不同的优先级。第1级队列的优先级最⾼,第2级队列的优先级次之,其余队列的优先级逐个降低。
- 赋予各个队列的进程运⾏时间⽚的⼤⼩各不相同。在优先级越⾼的队列中,每个进程的时间⽚就越⼩。例如,第 i+1 级队列的时间⽚要⽐第i级队列的时间⽚⻓1倍。
- 每个队列都采⽤FCFS算法。当新进程进⼊内存后,⾸先将它放⼊第1级队列的末尾,按FCFS原则等待调度。当轮到该进程执⾏时,如它能在该时间⽚内完成,便可撤离系统。若它在⼀个时间⽚结束时尚未完成,调度程序将其转⼊第2级队列的末尾等待调度:若它在第2级队列中运⾏⼀个时间⽚后仍未完成,再将它放⼊第3级队列…,依此类推。当进程最后被降到第n级队列后,在第n级队列中便采⽤时间⽚轮转⽅式运⾏。
- 按队列优先级调度。仅当第1级队列为空时,才调度第2级队列中的进程运⾏;仅当第 1~i-1 级队列均为空时,才会调度第i级队列中的进程运⾏。若处理机正在执⾏第i级队列中的某进程时,⼜有新进程进⼊任⼀优先级较⾼的队列,此时须⽴即把正在运⾏的进程放回到第级队列的末尾,⽽把处理机分配给新到的⾼优先级进程。
多级反馈队列的优势有以下几点:
- 终端型作业用户:短作业优先。
- 短批处理作业用户:周转时间较短
- 长批处理作业用户:经过前面几个队列得到部分执行,不会长期得不到处理。
Golang
数组与切片有什么异同
slice的底层数据是数组,slice是对数组的封装,它描述一个数组的片段。两者都可以通过下标来访问单个元素。
数组是定长的,长度定义好之后,不能再更改。在Go中,数组是不常见的,因为其长度是类型的一部分,限制了它的表达能力,比如[3]int和[4]int就是不同的类型。
而切片则非常灵活,它可以动态地扩容。切片的类型与长度无关。
数组就是一片连续的内存,slice实际上是一个结构体,包含三个字段:长度、容量、底层数组。
1 | |
slice的数据结构如下:
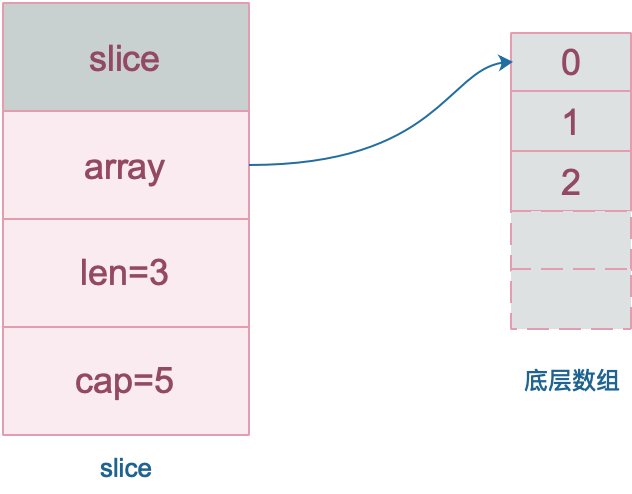
注意,底层数组是可以被多个slice同时指向的,因此对一个slice的元素进行操作是有可能影响到其他slice的。
【引申1】 [3]int 和 [4]int 是同一个类型吗?
不是。因为数组的长度是类型的一部分,这是与 slice 不同的一点。
【引申2】 下面的代码输出是什么?
说明:例子来自《Go学习笔记》第四版,P43页。
1 | |
结果:
1 | |
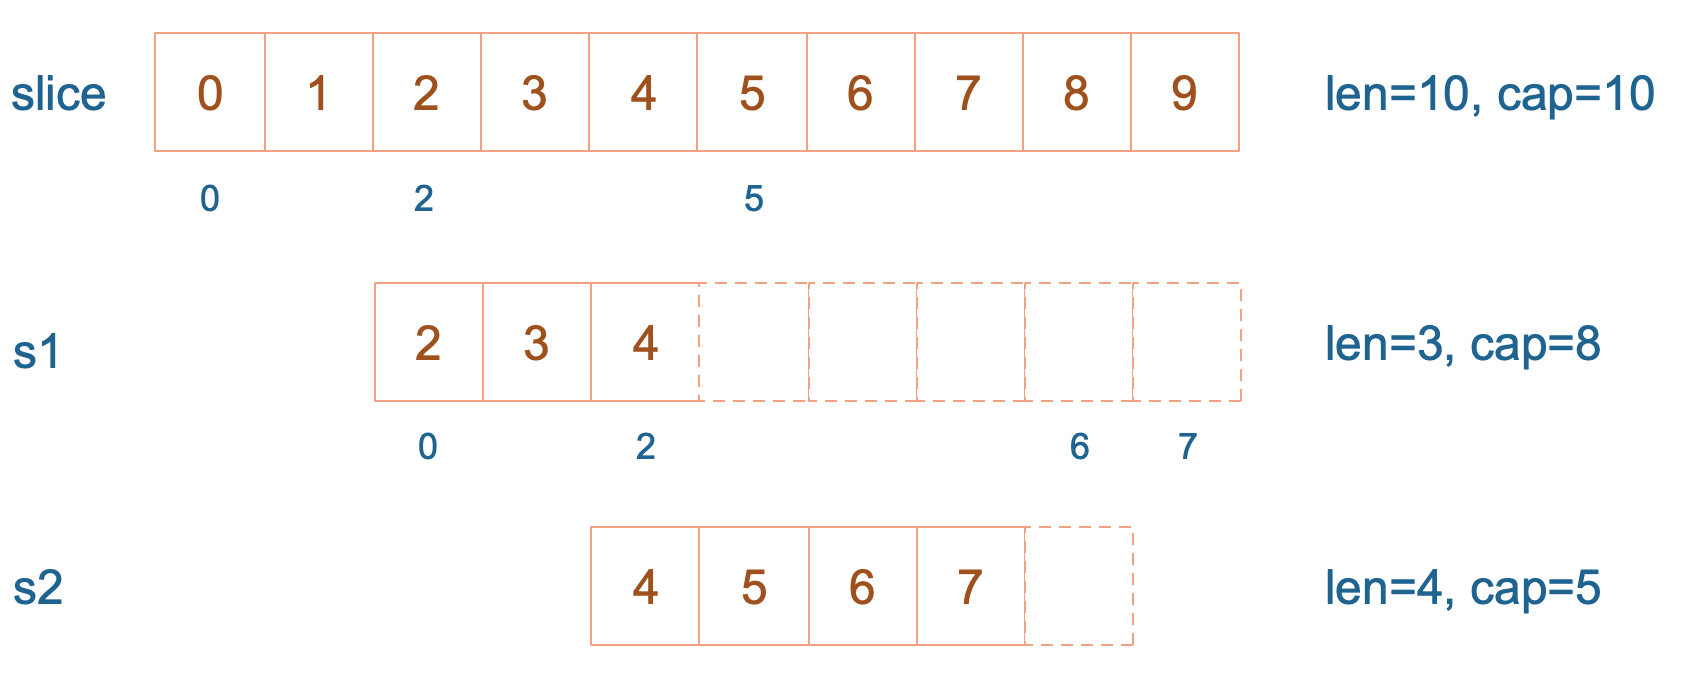
s1从slice索引2(闭区间)到索引5(开区间),长度为3,容器默认到数组结尾,为8.s2从s1的索引2闭区间到索引6(开区间),容量到索引7(开区间),为5
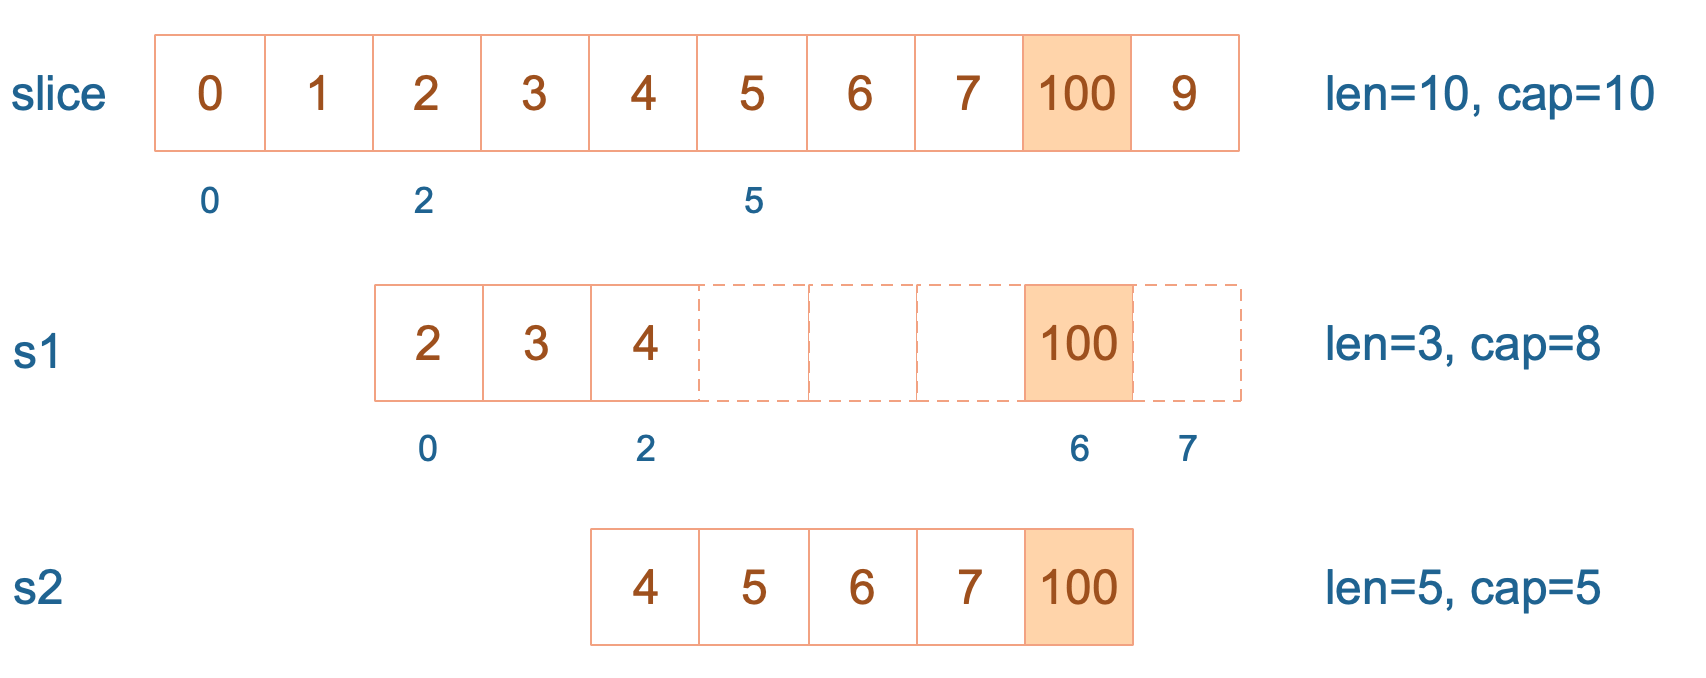
接着,向 s2 尾部追加一个元素 100:
1 | |
s2 容量刚好够,直接追加。不过,这会修改原始数组对应位置的元素。这一改动,数组和 s1 都可以看得到。
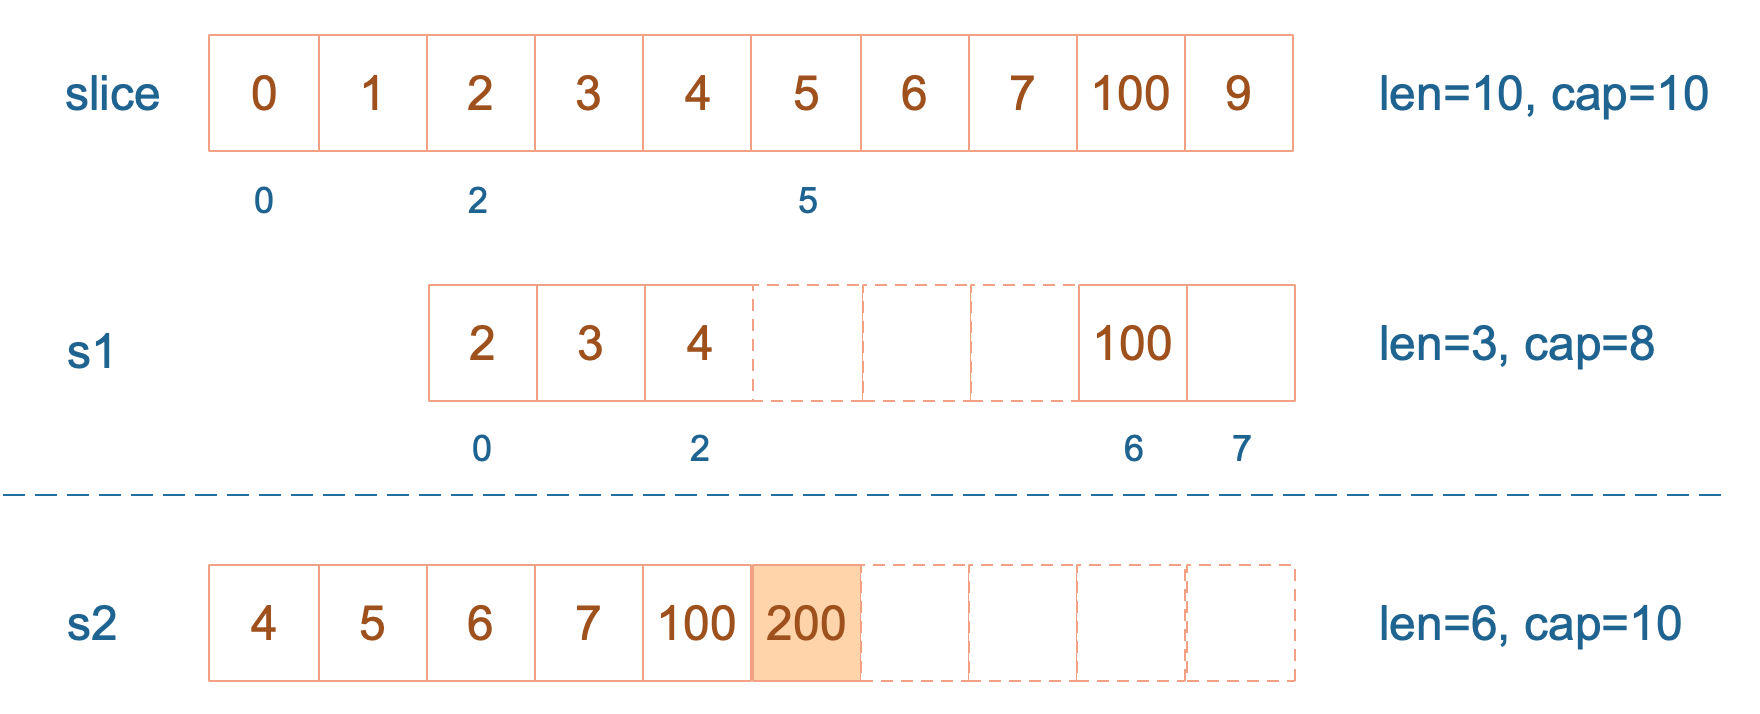
再次向 s2 追加元素200:
1 | |
这时,s2 的容量不够用,该扩容了。于是,s2 另起炉灶,将原来的元素复制新的位置,扩大自己的容量。并且为了应对未来可能的 append 带来的再一次扩容,s2 会在此次扩容的时候多留一些 buffer,将新的容量将扩大为原始容量的2倍,也就是10了。
最后,修改 s1 索引为2位置的元素:
1 | |
这次只会影响原始数组相应位置的元素。它影响不到 s2 了,人家已经远走高飞了。
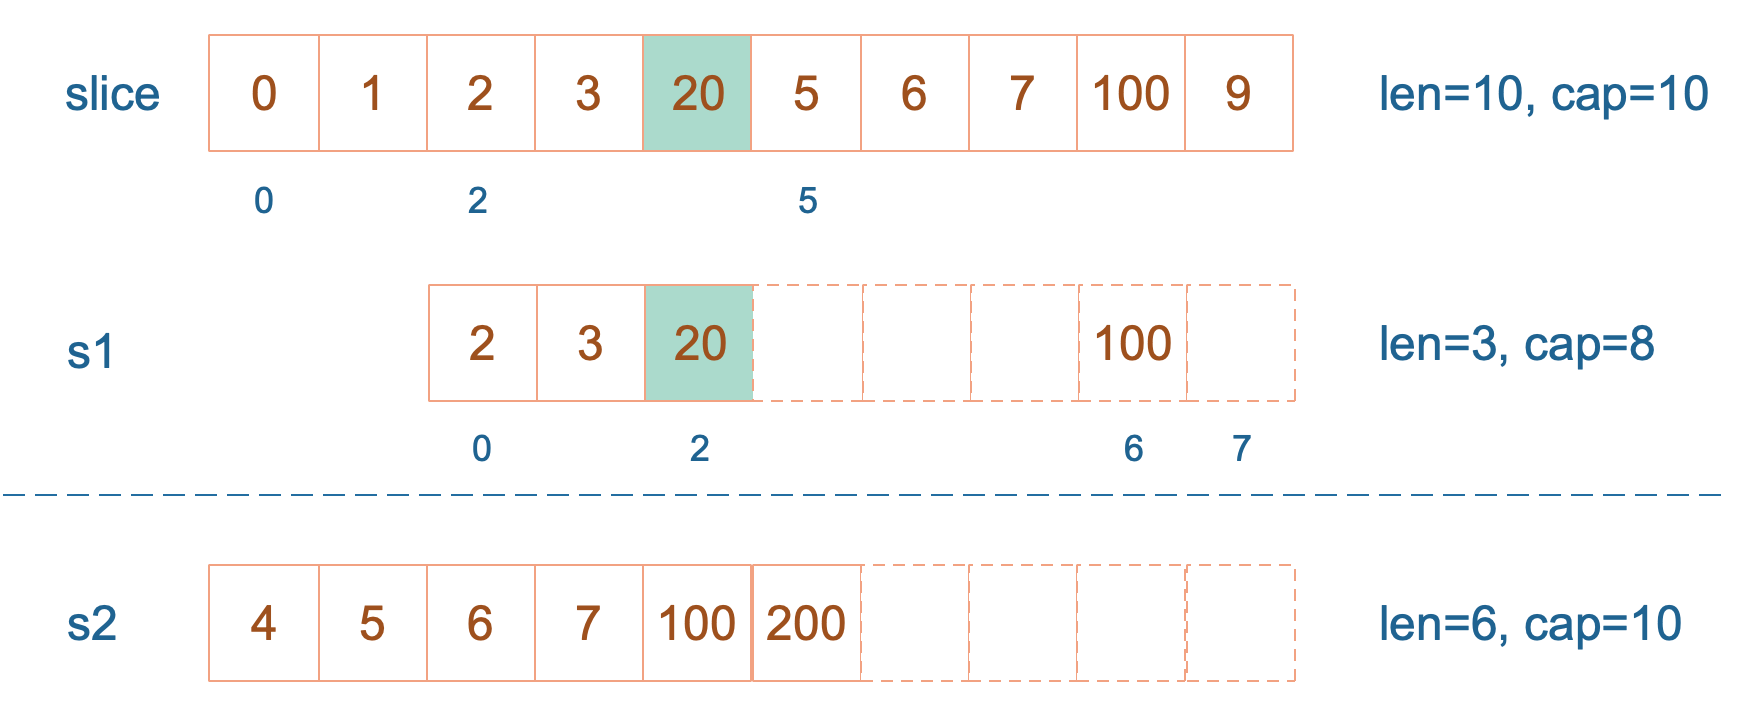
打印 s1 的时候,只会打印出 s1 长度以内的元素。所以,只会打印出3个元素,虽然它的底层数组不止3个元素。
总结
周六上午十点蚂蚁笔试,下午两点饿了么笔试(不是很匹配其实),周日看能不能面得物
感觉markdown还是不太熟练 啥时候进修一下子