13th-March
To-do List
[x] 算法
- [x] bfs && trie树
[ ] 项目
- [x] cmu15445
- [ ] mit6.824
- [ ] mit6.081
[ ] 八股
- [x] 操作系统
- [x] 计算机网络
- [ ] 数据库
- [ ] redis
- [x] 日常总结
1.算法
I.bfs
题面: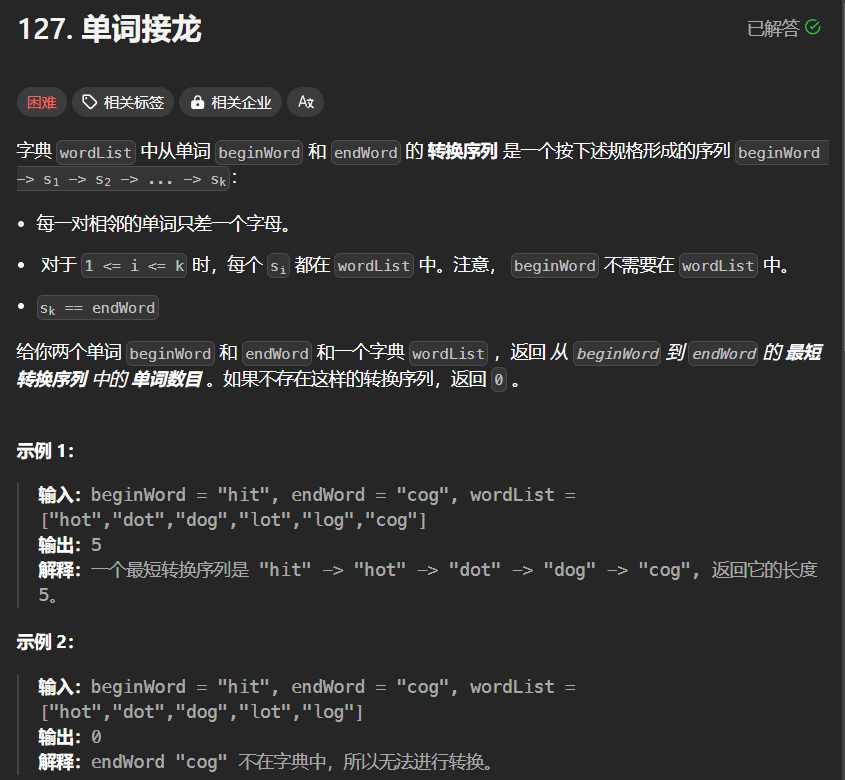
解答:其实都是很经典的队列bfs 和其他同类型的其他两个几乎一样 但是我也不知道为什么他是hard
用队列存储状态 然后再递归 理解bfs的精髓就好
1 | |
II.Trie树
题面:

题解:就不放经典的Trie了,这个才是真正的应用,将每个单词insert,再遍历整个二维数组用dfs,能访问到的就加入答案
Trie模板:
1 | |
dfs代码:
1 | |
2.项目
cmu15445
进度:p3task1 大概看了一下 主要是query plan? 到时候再看怎么看看代码
3.八股
计算机网络
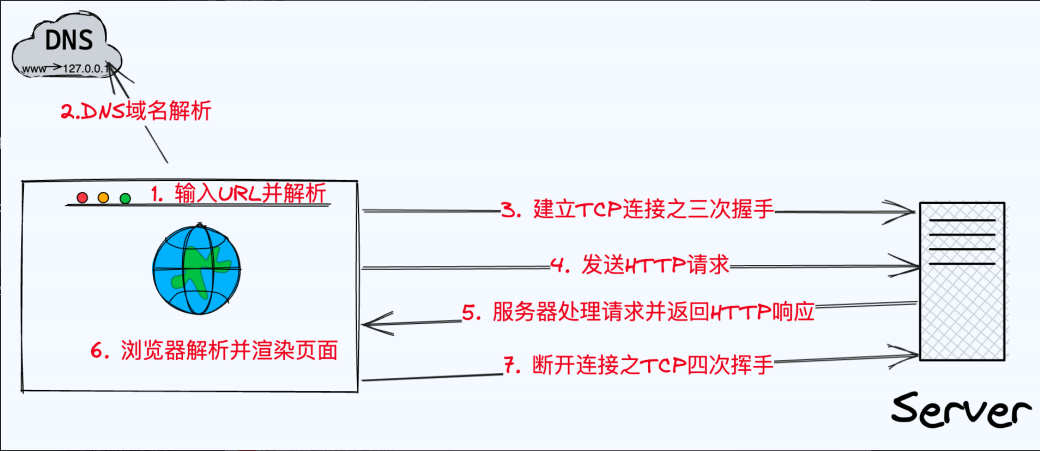
(1)在浏览器中输入URL并按下回车之后会发生什么
第一步:输入URL并解析
对URL进行解析,获得协议、主机、端口、路径等信息,并构造一个HTTP请求(强制缓存 or 协商缓存)
第二步:DNS域名解析
将域名解析为对应的IP地址
第三步:建立TCP三次握手链接
Q:为什么是三次,不是两次、四次?握手丢失会发生什么,过程中可以携带数据吗
第四步:浏览器发送HTTP/HTTPS请求到web服务器
Q:HTTP/HTTPS的区别,请求状态码1xx-5xx
第五步:服务器处理HTTP请求并返回HTTP报文
服务器接收请求并将其传递给请求处理程序并发送HTTP响应,内容:请求的网页以及状态码、压缩类型、如何缓存的页面、设置的cookie;
第六步:浏览器渲染页面
第七步:断开连接TCP4次握手
操作系统
进程和线程
1.进程基础
(1)进程的概念
我们编写的代码只是一个存储在硬盘的静态文件,通过编译后就会生成二进制可执行文件,当我们运行这个可执行文件后,它就会被装载到内存中,接着CPU会执行程序中的每一条指令,那么这个运行中的程序,就被称为 [进程](process)
所以说,进程是具有独立功能的程序在一个数据集合上运行的过程,是系统进行资源分配和调度的一个独立单位。
(2)进程控制块(PCB)
系统通过PCB来描述进程的基本情况和运行状态,进而控制和管理进程,它是进程存在的唯一标识,包括:进程描述信息、进程控制和管理信息、进程资源分配清单、CPU相关信息
PCB通常是通过链表的方式进行组织,把具有相同状态的进程链在一起,组成各种队列。
(3)并发与并行
单个处理核在很短时间内分别执行多个进程,成为并发
多个处理核同时执行多个进程称为并行
对于并发来说,CPU需要从一个进程切换到另一个进程,在切换前必须要记录当前进程中运行的状态信息,以备下次切换回来的时候可以恢复执行

(4)进程的状态切换
我们知道了并发会执行进程的切换,这就需要进程有运行状态和停止状态,实际上某个进程在某个时刻所处的态分为一下三种:
运行态:该时刻进程占用CPU
就绪态:可运行,由于其他进程处于运行状态而暂停运行
阻塞态:该进程正在等待某一事件的发生(如IO操作)而暂时停止运行
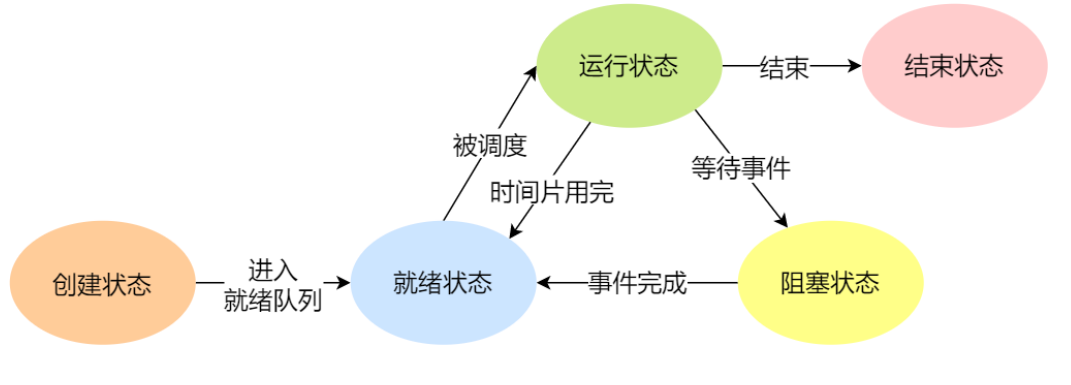
如果有大量处于阻塞状态的进程,进程可能会占用着物理内存空间,所以系统通常会把阻塞状态的进程的物理内存空间换出到硬盘,等需要再次运行的时候,再从硬盘换入到物理内存,那么就需要一个新的状态,来描述进程没有占用实际的物理内存空间的情况,这个状态就是挂起状态。这跟阻塞状态是不一样的,阻塞是等待某个时间的返回。
分为阻塞挂起和阻塞就绪状态
(5)进程的上下文切换
一个进程切换到另一个进程运行,称为进程的上下文切换,进程的上下文切换不仅包含了虚拟内存、栈、全局变量等用户空间的资源,还包括内核堆栈、寄存器等内核空间的资源。
(6)进程的创建
一个进程可以创建另一个进程,此时创建者为父进程,被创建的进程为子进程,操作系统创建一个新进程的过程如下:
- 为新进程分配一个独特的进程控制块(PCB)
- 为新进程分配所需要的资源,如内存、CPU时间等
- 初始化进程控制块(PCB)的各种字段,包括状态、优先级、寄存器初始值等。
- 将其状态设置为就绪状态,使其能够被调度执行。进程进入就绪队列,等待分配处理器时间。
(7)进程的终止
- 根据标识符,查找需要终止的进程的PCB
- 如果进程处于执行状态,则立即终止该进程的执行,然后将处理器资源分配给其他进程
- 如果还有子进程,则将其子进程交给1号进程接管
- 将该进程所拥有的全部资源都归还给操作系统
- 将其从PCB所在队列中删除
(8)进程的阻塞
- 找到被阻塞进程的标识符对应的PCB
- 如果该进程为运行状态,则保护其现场,将其状态转为阻塞状态,停止运行
- 将该PCB插入到等待队列中,将处理机资源调度给其他就绪进程
(9)进程的唤醒
- 在该事件的阻塞队列中找到相应进程的PCB
- 将其从阻塞队列中移出,并置为就绪状态
- 将PCB插入到就绪队列中,等待调度程序调度
2.线程基础
(1)什么是线程?
线程是“轻量级线程”,是进程中的一个实体,是程序执行的最小单位,也是被系统独立调度和分配的基本单位。
线程是进程当中的一条执行流程,同一个进程内多个线程之间可以共享代码段、数据段、打开的文件等资源,但每个线程各自都有一套独立的寄存器和栈,这样可以确保线程的控制流是相互独立的。
(2)线程的特点
- 线程是一个“轻量级线程”,一个进程中可以有多个线程,线程不拥有系统资源,但是也有PCB,创建线程使用的底层函数和进程一样,都是clone
- 各个线程之间可以并发执行
- 同一个进程中的各个线程共享该进程所拥有的资源
- 进程可以蜕变成线程
实际上,无论是创建进程的fork,还是创建线程的pthread_create,底层实现都是调用同一个内核函数clone
linux内核是不区分线程和进程的,只在用户层面上进行区分。所以,线程所有操作函数pthread_*是库函数,而非系统调用
(3)进程和线程的比较
进程是资源(包括内存、打开的文件等)分配的单位,线程是CPU调度的单位
- 资源:进程是系统中拥有资源的基本单位,而线程不拥有系统资源(只有寄存器和栈),但线程可以访问隶属进程的系统资源
- 调度:线程切换的代价远低于进程,在同一个进程中,线程的切换不会引起进程切换,而从一个进程中的线程切换到另一个进程的线程中,会引起进程切换
- 并发:进程可以并发执行,而一个进程中的多个线程之间也能并发执行,甚至不同进程中的线程也能并发执行,从而是的操作系统拥有更好的并发性,提高了系统资源的利用率和系统的吞吐量
- 独立性:每个进程都拥有独⽴的地址空间和资源、除了共享全局变量,不允许其他进程访问。某进程中的线程对其他进程都不可⻅,同⼀进程中的不同线程是为了提⾼并发性以及进⾏相互之间的合作⽽创建的,它们共享进程的地址空间和资源。
- 系统开销:线程所需要的开销比进程小
(4)线程的状态:
- 执行状态
- 就绪状态
- 阻塞状态
(5)线程的实现
- 用户线程:用户空间实现的线程,操作系统不直接参与
- 内核线程:操作系统管理、调度,PCB存放在内核中
- 轻量级线程:内核支持的用户线程
(6)线程共享资源
- 文件描述符表
- 每种信号的处理方式
- 当前工作目录
- 用户ID和组ID
(7)线程非共享资源
- 线程id
- 处理器现场和栈指针
- 独立的栈空间
- errno变量(?这是什么)
- 信号屏蔽字
- 调度优先级
(8)线程的优缺点
优点:
- 提高程序并发性
- 开销小
- 数据通信、共享数据方便
缺点:
- 库函数,不稳定
- 调试、编写困难、gdb不支持
- 对信号支持不好
(9)线程如何减少开销
- 线程创建快、进程创建需要资源管理信息,比如内存管理信息和文件管理信息,而线程创建后是共享其所属进程的资源管理信息
- 线程终止时间快,需回收的仅有少量寄存器和私有的栈区
- 线程切换快,因为线程切换仅涉及到少量寄存器和栈区,而进程上下文切换有CPU寄存器和程序寄存器、虚拟内存空间、页表切换等
- 线程因为创建时共享了其所属进程绝大多数资源,因此天生具有很好的线程间通信交互效率
4.总结
投递进度
| 公司 | 进度 | 备注 |
|---|---|---|
| 字节 | 简历评估 | |
| 快手 | 系统研发存储 已投 | |
| 携程 | 已投 |