mapreduce
MapReduce:在大型集群上的简易数据处理
摘要
MapReduce是一种用于处理和生成大型数据集的编程模型和相关实现。用户使用map函数处理kv对,生成一个中间value和中间key,使用reduce函数merge所有的中间kv键。很多现实世界任务都可以用这个模型来表示。
用这种函数式风格编写的程序被自动并行化,并在大量的商用机器上执行。运行时系统负责对输入数据进行分区、在一组机器上调度程序的执行、处理机器故障以及管理所需的机器间通信等细节。这让程序员不需要理解并行和分布式系统就能很轻易地使用大型分布式系统的资源。
1 介绍:sweat_drops:
在过去的五年中,作者和谷歌的许多其他人已经实现了数百种特殊用途的计算,这些计算处理大量的原始数据,如抓取的文档、web请求日志等,以计算各种派生数据,如倒排索引、web文档的图形结构的各种表示、每个主机抓取的页面数量的摘要、给定一天中最频繁的查询集等。大多数这样的计算在概念上是直截了当的。然而,输入数据通常很大,计算必须分布在数百或数千台机器上,以便在合理的时间内完成。如何并行化计算、分布数据和处理故障等问题,使得原始的简单计算用大量复杂的代码来处理这些问题变得模糊不清。
作为对这种复杂性的反应,我们设计了一个新的抽象,它允许我们表达我们试图执行的简单计算,但隐藏了库中并行化、容错、数据分布和负载平衡的混乱细节。我们的抽象受到Lisp和其他函数式语言中map和reduce原语的启发。我们意识到,大多数计算涉及对输入中每个逻辑“记录”应用map操作,以计算一组中间键/值对,然后对共享同一键的所有值应用reduce操作,以便适当地组合派生数据。通过使用带有用户指定map和reduce操作的功能模型,我们能够轻松并行化大型计算,并将重新执行作为主要容错机制。
这个工作的主要贡献是一个简单但强大的支持大规模计算的自动并行化和分布的接口。与此接口的实现相结合,在大型商用pc集群上实现高性能。第2节描述了基本的编程模型,并给出了几个示例。第3节描述了针对基于集群的计算环境量身定制的MapReduce接口的实现。第4节描述了我们认为有用的编程模型的几个改进。第5节对各种任务的实现进行了性能度量。第6节探讨了MapReduce在Google中的使用,包括我们使用它作为重写我们的生产索引系统的基础的经验。第7节讨论了相关的和未来的工作。
2 编程模型:sweat_drops:
计算需要一组kv对输入,并且输出一组kv对。mapreduce主要是两个函数:Map和Reduce。
Map接受一个输入对并且产生一个中间kv对。MapReduce库将与中间keyI相同的的所有中间值分组,并且把它们传递到Reduce函数中。
Reduce函数接受一个中间keyI和一组与key相对应的value,它将这些value合并起来形成一个可能更小的值集,一般是输出一个key一个value。中间值通过迭代器提供给用户的reduce函数。这允许我们处理大到内存无法容纳的值列表。
2.1 Example
单词计数器,伪代码:
1 | |
map函数发出每个单词加上相关的出现次数计数,reduce函数将针对特定单词发出的所有计数求和。
此外,用户编写代码,用输入和输出文件的名称以及可选的调优参数填充mapreduce规范对象。然后,用户调用MapReduce函数,将规范对象传递给它。用户的代码与MapReduce库(用c++实现)链接在一起。附录A包含这个示例的完整程序文本。
2.2 Types
尽管前面的伪代码是根据字符串输入和输出编写的,但从概念上讲,用户提供的map和reduce函数具有相关的类型:
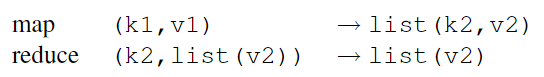
输入键和值是从与输出键和值不同的域中绘制的。此外,中间键和值与输出键和值来自相同的domain。
我们的c++实现将字符串传递给用户定义函数,并将其留给用户代码在字符串和适当类型之间进行转换。
2.3 More Examples
Distributed Grep: 如果map函数匹配提供的模式,则会发出一行。reduce函数是一个恒等函数,它只是将提供的中间数据复制到输出。
Count of URL Access Frequency: map函数处理web页面请求日志,输出
Reverse Web-Link Graph: map函数为在名为source的页面中找到的每个指向目标URL的链接输出
Term-Vector per Host: 术语向量是将文档或一组文档中最重要的单词总结为
Inverted Index: map函数解析每个文档,并发出
Distributed Sort: map函数从每个记录中提取键,并发出一个
3 实现
MapReduce接口可能有许多不同的实现。正确的选择取决于环境。例如,一种实现可能适用于小型共享内存机器,另一种适用于大型NUMA多处理器,还有一种适用于更大的联网机器集合。
本节描述了针对Google广泛使用的计算环境的实现:大型商用pc集群通过交换以太网连接在一起。在我们的环境中:
- 机器通常是运行Linux的双处理器x86处理器,每台机器有2-4 GB内存。
- 使用的是商用网络硬件——通常在机器级别上是100兆比特/秒或1千兆比特/秒,但总体对分带宽平均要少得多。
- 集群由数百或数千台机器组成,因此机器故障很常见。
- 存储由直接连接到单个机器上的廉价IDE磁盘提供。内部开发的分布式文件系统用于管理存储在这些磁盘上的数据。文件系统使用复制在不可靠的硬件之上提供可用性和可靠性。
- 用户向调度系统提交作业。每个作业由一组任务组成,并由调度器映射到集群中的一组可用机器。
3.1 执行概述
通过自动将输入数据划分为M段,Map调用可以在多台机器上进行分布式处理。不同的机器可以并行处理输入分割。Reduce调用是通过使用分区函数(例如hash(key) mod R)将中间键空间划分为R块来进行分发的。用户可以指定要使用的分区数量(R)和分区函数。
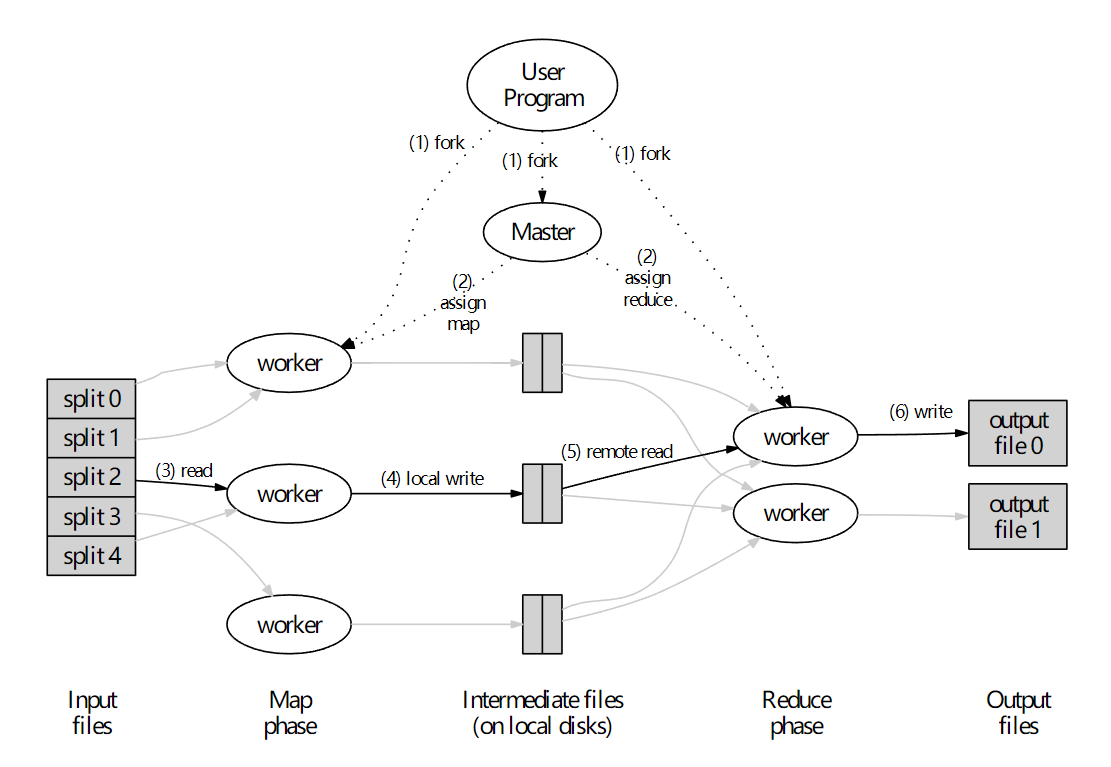
图1显示了我们实现中MapReduce操作的整体流程。当用户程序调用MapReduce函数时,会发生以下一系列动作(图1中的编号标签对应于下面列表中的数字):
- MapReduce库将输入文件从m个16-64mb的小文件,然后,它在一个机器集群上启动该程序的许多副本。
- 这个节目的其中一份拷贝是特别的——master。其余的是由master分配工作的worker。有M个map任务和R个reduce任务要分配。主机选择空闲的worker,并为每个worker分配一个map任务或reduce任务。
- 被分配映射任务的worker线程读取相应输入分割的内容。它从输入数据中解析键/值对,并将每对传递给用户定义的Map函数。Map函数产生的中间键/值对在内存中进行缓冲。
- 周期性地将缓冲对写入本地磁盘,并通过分区函数划分为R个区域。这些缓冲对在本地磁盘上的位置被传递回主服务器,主服务器负责将这些位置转发给reduce worker。
- 当主服务器通知reduce worker有关这些位置时,它使用远程过程调用从map worker的本地磁盘读取缓冲数据。当reduce工作程序读取了所有中间数据后,它按中间键对数据进行排序,以便将所有出现的相同键分组在一起。排序是必要的,因为通常有许多不同的键映射到相同的reduce任务。如果中间数据量太大,内存无法容纳,则使用外部排序。
- reduce worker遍历已排序的中间数据,对于遇到的每个唯一的中间键,它将键和相应的中间值集传递给用户的reduce函数。Reduce函数的输出被附加到这个Reduce分区的最终输出文件中。
- 当所有map任务和reduce任务完成后,主程序唤醒用户程序。此时,用户程序中的MapReduce调用返回到用户代码。
成功完成后,maprereduce执行的输出在R输出文件中可用(每个reduce任务一个,文件名由用户指定)。通常,用户不需要将这些R输出文件合并到一个文件中——他们经常将这些文件作为输入传递给另一个MapReduce调用,或者从另一个能够处理分区为多个文件的输入的分布式应用程序中使用它们。
3.2 master数据结构
master保留了几个数据结构。对于每个map任务和reduce任务,它存储状态(空闲、正在进行或已完成)以及工作机器的标识(对于非空闲任务)。
主节点是将中间文件区域的位置从map任务传播到reduce任务的通道。因此,对于每一个完成的map任务,master存储由map任务产生的R个中间文件区域的位置和大小。当地图任务完成时,会收到对该位置和大小信息的更新。这些信息被逐步推送给正在执行减少任务的工作人员。
3.3 容错性
由于MapReduce库的设计目的是帮助处理使用数百或数千台机器的大量数据,因此库必须优雅地容忍机器故障。
worker
主服务器定期ping每个worker。如果在一定时间内没有收到来自worker的响应,则主程序将该worker标记为失败。该worker完成的任何map任务都将被重置回其初始空闲状态,因此可以在其他worker上进行调度。类似地,在失败的worker上正在进行的任何map任务或reduce任务也被重置为空闲,并有资格重新调度。
完成的映射任务在发生故障时重新执行,因为它们的输出存储在故障机器的本地磁盘上,因此无法访问。完成的reduce任务不需要重新执行,因为它们的输出存储在全局文件系统中。
当一个映射任务首先由工人a执行,然后由工人B执行(因为a失败了),所有的执行reduce任务的worker会收到重新执行的通知。任何尚未从worker A读取数据的reduce任务都将从worker B读取数据。
MapReduce对大规模worker故障具有弹性。例如,在一次MapReduce操作期间,正在运行的集群上的网络维护导致80台机器组成的组在几分钟内无法访问。MapReduce主节点只是重新执行无法到达的工作机器所做的工作,并继续向前推进,最终完成MapReduce操作。
master
让主写入上述主数据结构的定期检查点是很容易的。如果主任务终止,则可以从最后一个检查点状态开始新的副本。然而,考虑到只有一个主人,它不太可能失败;因此,如果主节点失败,我们当前的实现会中止MapReduce的计算。客户端可以检查这种情况,如果需要的话,可以重试MapReduce操作。
故障时的语义表现
当用户提供的map和reduce操作符是其输入值的确定性函数时,我们的分布式实现产生的输出与整个程序的非错误顺序执行所产生的输出相同。
我们依靠map的原子提交和reduce任务输出来实现这个属性。每个正在进行的任务将其输出写入私有临时文件。一个reduce任务生成一个这样的文件,一个map任务生成R个这样的文件(每个reduce任务生成一个)。当map任务完成时,worker向master发送一条消息,并在消息中包含R临时文件的名称。如果主机接收到已经完成的映射任务的完成消息,则忽略该消息。否则,它将在主数据结构中记录R文件的名称。
当reduce任务完成时,reduce worker自动将其临时输出文件重命名为最终输出文件。如果在多台机器上执行相同的reduce任务,则将对相同的最终输出文件执行多个重命名调用。我们依赖底层文件系统提供的原子重命名操作来保证最终文件系统状态只包含一次reduce任务执行所产生的数据。
我们的绝大多数map和reduce操作符都是确定性的,在这种情况下,我们的语义等同于顺序执行,这使得程序员很容易推断他们的程序行为。当map和/或reduce操作符不确定时,我们提供较弱但仍然合理的语义。在存在非确定性操作符的情况下,特定reduce任务R1的输出相当于非确定性程序的顺序执行对R1产生的输出。然而,不同的reduce任务R2的输出可能对应于不确定性程序的不同顺序执行所产生的R2的输出。
考虑map任务M和reduce任务R1和R2。设e(Ri)为所提交的Ri的执行(只有一次这样的执行)较弱的语义出现是因为e(R1)可能读取了一次M执行产生的输出,而e(R2)可能读取了另一次M执行产生的输出。
3.4 Locality
网络带宽在我们的计算环境中是一种相对稀缺的资源。我们利用输入数据(由GFS管理)存储在组成集群的机器的本地磁盘这一事实来节省网络带宽。GFS将每个文件划分为64 MB的块,并在不同的机器上存储每个块的几个副本(通常是3个副本)。MapReduce主程序将输入文件的位置信息考虑在内,并尝试在包含相应输入数据副本的机器上调度地图任务。如果失败,它会尝试在该任务输入数据的副本附近调度一个map任务(例如,在与包含数据的机器位于同一网络交换机上的工作机器上)。当在集群中相当一部分worker上运行大型MapReduce操作时,大多数输入数据都是在本地读取的,不消耗网络带宽。
3.5 任务粒度
我们将map阶段细分为M个片段,reduce阶段细分为R个片段,如上所述。理想情况下,M和R应该比工作机器的数量大得多。让每个worker执行许多不同的任务可以改善动态负载平衡,并且还可以在一个worker失败时加快恢复速度:它完成的许多map任务可以分散到所有其他worker机器上。
在我们的实现中,M和R的大小是有实际限制的,因为主机必须做出O(M + R)个调度决策,并如上所述在内存中保持O(M R)个状态。(然而,内存使用的恒定因素很小:状态的O(M R)块由每个map任务/reduce任务对大约一个字节的数据组成。)
此外,R经常受到用户的约束,因为每个reduce任务的输出最终都在一个单独的输出文件中。在实践中,我们倾向于选择M,这样每个单独的任务大约有16 MB到64 MB的输入数据(这样上面描述的局部性优化是最有效的),我们让R是我们期望使用的工作机器数量的一个小倍数。我们经常使用2000台工作机器,在M = 200000和R = 5000的情况下执行MapReduce计算。
3.6 备份任务
导致MapReduce操作总时间延长的常见原因之一是“掉队者”:在计算过程中,一台机器花了很长时间才完成最后几个map或reduce任务中的一个。掉队者的出现有很多原因。例如,具有坏磁盘的机器可能会遇到频繁的可纠正错误,从而使其读取性能从30 MB/s降低到1 MB/s。集群调度系统可能已经调度了机器上的其他任务,由于CPU、内存、本地磁盘或网络带宽的竞争,导致它执行MapReduce代码的速度更慢。我们最近遇到的一个问题是机器初始化代码中的一个错误,它导致处理器缓存被禁用:受影响的机器上的计算速度减慢了一百多倍。
我们有一个通用的机制来缓解掉队者的问题。当一个MapReduce操作接近完成时,master调度剩余正在执行的任务执行备份。每当主执行或备份执行完成时,任务就被标记为已完成。我们已经对这种机制进行了调优,使它通常只增加操作所使用的计算资源几个百分点。我们发现这大大减少了完成大型MapReduce操作的时间。例如,当备份任务机制被禁用时,5.3节中描述的排序程序要多花44%的时间来完成。
4 改进
虽然简单编写Map和Reduce函数提供的基本功能足以满足大多数需求,但我们发现一些扩展很有用。本节将介绍这些特性。
4.1 分区函数
MapReduce的用户可以指定他们想要的reduce任务/输出文件数量(R)。使用中间键上的分区函数在这些任务之间对数据进行分区。提供了一个默认使用哈希函数进行分区(例如“hash(key) mod R”),通常会产生相当均衡的分区结果。然而,在某些情况下,根据键值的其他函数对数据进行分区是有用的。例如,当输出键为url时,我们希望将同一主机上所有条目都放置在同一个输出文件中。为了支持这种情况,MapReduce库允许用户提供特殊的分区函数。例如,使用“hash(Hostname(urlkey)) mod R”作为分区函数将导致来自同一主机的所有url最终出现在相同的输出文件中。
4.2 排序保证
保证在给定分区内,中间键/值对按键或递增顺序处理。这种排序保证可以很容易地为每个分区生成排序的输出文件,当输出文件格式需要支持有效的按键随机访问查找时,或者输出的用户发现对数据进行排序很方便时,这是很有用的。
4.3 Combiner
在某些情况下,每个map任务产生的中间键存在显著的重复,并且用户指定的Reduce函数是可交换的和关联的。第2.1节中的单词计数就是一个很好的例子。由于词频倾向于遵循Zipf分布,每个地图任务将产生成百上千条形式为<the, 1>的记录。所有这些计数将通过网络发送到一个Reduce任务,然后由Reduce函数将它们加在一起生成一个数字。我们允许用户指定一个可选的Combiner函数,该函数在数据通过网络发送之前对其进行部分合并。
Combiner函数在每台执行映射任务的机器上执行。通常使用相同的代码来实现combiner和reduce函数。reduce函数和组合函数之间的唯一区别是MapReduce库如何处理函数的输出。reduce函数的输出被写入最终的输出文件。组合函数的输出被写入中间文件,该中间文件将被发送给reduce任务。
部分组合显著加快了某些类型的MapReduce操作。附录A包含一个使用组合器的示例。
4.4 输入和输出类型
MapReduce库支持以几种不同的格式读取输入数据。比如,“text”模式输入将每行视为一个键/值对:键是文件中的偏移量,值是该行的内容。另一种常见的支持格式存储按键排序的键/值对序列。每个输入类型实现都知道如何将自己分割成有意义的范围,以便作为单独的map任务进行处理(例如,文本模式的范围分割确保范围分割仅在行边界发生)。用户可以通过提供简单阅读器界面的实现来添加对新输入类型的支持,尽管大多数用户只使用少数预定义输入类型中的一种。
读取器不一定需要提供从文件读取的数据。例如,很容易定义从数据库或从内存中映射的数据结构中读取记录的读取器。
以类似的方式,我们支持一组输出类型来生成不同格式的数据,并且用户代码很容易添加对新输出类型的支持。
4.5 副作用
在某些情况下,MapReduce的用户发现从他们的map和/或reduce操作符生成辅助文件作为附加输出是很方便的。我们依靠应用程序编写器使这些副作用原子化和幂等化。通常,应用程序写入临时文件,并在完全生成该文件后自动重命名该文件。
我们不支持单个任务生成的多个输出文件的原子两阶段提交。因此,产生具有跨文件一致性要求的多个输出文件的任务应该是确定性的。这种限制在实践中从来没有成为问题。
4.6 跳过坏记录
有时,用户代码中的错误会导致Map或Reduce函数在某些记录上崩溃。这样的bug会导致MapReduce操作无法完成。通常的做法是修复漏洞,但有时这是不可行的;也许这个bug是在一个第三方库中,源代码是不可用的。此外,有时忽略一些记录也是可以接受的,例如在对大型数据集进行统计分析时。我们提供了一种可选的执行模式,其中MapReduce库检测哪些记录导致确定性崩溃,并跳过这些记录,以便向前推进。
每个工作进程安装一个信号处理程序,用于捕获分段违反和总线错误。在调用用户Map或Reduce操作之前,mapreduce库将参数的序列号存储在一个全局变量中。如果用户代码生成一个信号,信号处理程序发送一个包含序列号的“最后喘息”UDP数据包到MapReduce主服务器。当主服务器在一个特定的记录上看到多个失败时,它表明在下一次重新执行相应的Map或Reduce任务时应该跳过该记录。
4.7 本地执行
Map或Reduce函数中的调试问题可能很棘手,因为实际的计算发生在分布式系统中,通常在数千台机器上,工作分配决策是由主机动态做出的。为了方便调试、分析和小规模测试,我们开发了MapReduce库的另一种实现,它在本地机器上顺序地执行MapReduce操作的所有工作。控件提供给用户,这样计算就可以限制在特定的地图任务上。用户用一个特殊的标志来调用他们的程序,然后可以很容易地使用他们认为有用的任何调试或测试工具(例如gdb)。
4.8 状态信息
主服务器运行一个内部HTTP服务器,并导出一组状态页供人们使用。状态页显示计算的进度,例如已经完成了多少个任务、正在进行多少个任务、输入字节数、中间数据字节数、输出字节数、处理速率等。这些页面还包含到每个任务生成的标准错误和标准输出文件的链接。用户可以使用这些数据来预测计算需要多长时间,以及是否应该在计算中添加更多的资源。这些页面还可用于确定何时计算比预期慢得多。
此外,顶级状态页显示哪些工人失败了,以及他们失败时正在处理哪些映射和减少任务。当试图诊断用户代码中的错误时,此信息非常有用。
4.9 Counters
MapReduce库提供了一个计数器工具来计算各种事件的发生次数。例如,用户代码可能想要计算处理的单词总数或索引的德语文档的数量等。
要使用此功能,用户代码创建一个命名计数器对象,然后在Map和/或Reduce函数中适当地增加计数器。例如:
1 | |
来自各个工作机器的计数器值定期传播到主机器(在ping响应的基础上)。master从成功的map和reduce任务中聚合计数器值,并在MapReduce操作完成时返回给用户代码。当前计数器的值也显示在主状态页面上,以便人们可以观看实时计算的进度。在聚合计数器值时,主服务器消除了重复执行相同映射或reduce任务的影响,以避免重复计数。(重复执行可能来自我们使用备份任务和由于失败而重新执行任务。
)
一些计数器值由MapReduce库自动维护,例如处理的输入键/值对的数量和产生的输出键/值对的数量。
用户发现计数器功能对于安全检查MapReduce操作的行为很有用。例如,在一些MapReduce操作中,用户代码可能希望确保生成的输出对的数量恰好等于处理的输入对的数量,或者处理的德语文档的比例在处理的文档总数的某个可容忍的比例之内。
5 Performance
主要是一些性能的测试,就分析图片吧
集群配置:所有的程序都在一个由大约1800台机器组成的集群上执行。每台机器都有两个2GHz英特尔至强处理器,支持超线程,4GB内存,两个160GB IDE磁盘和千兆以太网链路。这些机器被安排在一个两级树状交换网络中,根节点的总带宽约为100- 200gbps。所有的机器都在同一个托管设施中,因此任何一对机器之间的往返时间都小于1毫秒。在4GB内存中,大约有1-1.5GB是由集群上运行的其他任务保留的。这些程序是在一个周末的下午执行的,当时cpu、磁盘和网络大多处于空闲状态。
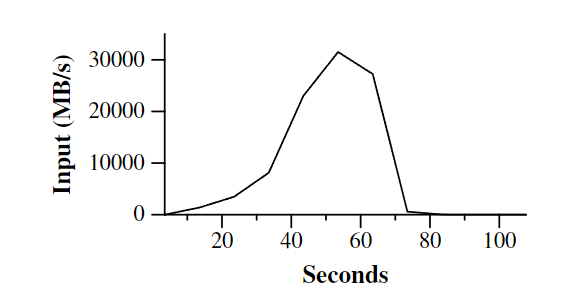
图2显示了计算随时间的进展。y轴表示扫描输入数据的速率。当更多的机器被分配到这个MapReduce计算时,速率逐渐回升,当分配了1764个worker时,速率超过30GB/s。当地图任务完成时,速率开始下降,并在计算后80秒左右达到零。整个计算从开始到结束大约需要150秒。这包括大约一分钟的启动开销。开销是由于将程序传播到所有工作机器,以及延迟与GFS交互以打开1000个输入文件集并获得局部性优化所需的信息。
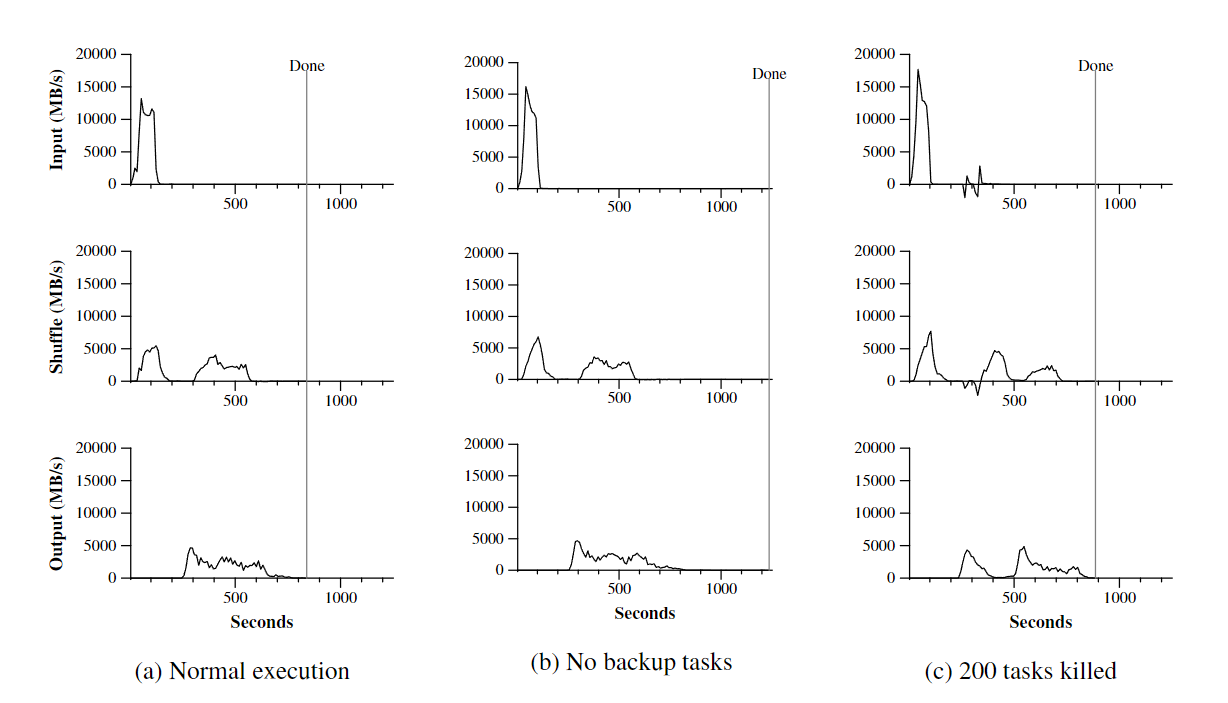
图3 (a)显示了排序程序正常执行的进度。左上角的图表显示了读取输入的速率。速率峰值约为13gb /s,并且很快就会消失,因为所有的map任务在200秒内就完成了。注意,输入速率小于grep。这是因为排序映射任务花费大约一半的时间和I/O带宽将中间输出写入本地磁盘。grep对应的中间输出的大小可以忽略不计。
左中图显示了数据通过网络从map任务发送到reduce任务的速率。当第一个map任务完成时,shuffle就开始了。图中的第一个驼峰是第一批大约1700个reduce任务(整个MapReduce被分配了大约1700台机器,每台机器一次最多执行一个reduce任务)。在大约300秒的计算中,第一批reduce任务中的一些完成了,我们开始为剩余的reduce任务转移数据。所有的洗牌在计算后大约600秒完成
左下角的图表显示了reduce任务将排序后的数据写入最终输出文件的速率。在第一个洗牌周期的结束和写入周期的开始之间有一个延迟,因为机器忙于对中间数据进行排序。继续以大约2-4 GB/s的速率写一段时间。所有的写操作在计算完成后大约850秒完成。包括启动开销在内,整个计算耗时891秒。这与目前TeraSort基准测试1057秒的最佳报告结果相似。
在图3 (b)中,我们展示了禁用备份任务的排序程序的执行。执行流与图3 (a)中所示的类似,除了有一个非常长的尾,几乎没有任何写活动发生。960秒后,除5个reduce任务外,其余的reduce任务都完成了。然而,这些最后几名落伍者直到300秒后才完成比赛。整个计算耗时1283秒,运行时间增加了44%。
在图3 (c)中,我们展示了排序程序的执行,在计算开始几分钟后,我们故意杀死了1746个工作进程中的200个。底层集群调度器立即重新启动这些机器上的新工作进程(因为只有进程被终止,机器仍然正常运行)。
6 相关工作
许多系统提供了受限的编程模型,并利用这些约束自动并行化计算。例如,可以在N个处理器上使用并行前缀计算,在log N时间内对N个元素数组的所有前缀计算一个关联函数。MapReduce可以被认为是基于我们在现实世界中大量计算的经验对这些模型的简化和提炼。更重要的是,我们提供了可扩展到数千个处理器的容错实现。相比之下,大多数并行处理系统只在较小的规模上实现,并将处理机器故障的细节留给程序员。
批量同步编程和一些MPI原语提供了更高级的抽象,使程序员更容易编写并行程序。这些系统和MapReduce之间的一个关键区别是,MapReduce利用一个受限的编程模型来自动并行化用户程序,并提供透明的容错。
我们的局部性优化从活动磁盘等技术中获得灵感,其中计算被推进到靠近本地磁盘的处理元素中,以减少通过I/O子系统或网络发送的数据量。我们在直接连接少量磁盘的普通处理器上运行,而不是直接在磁盘控制器处理器上运行,但一般方法是相似的。
我们的备份任务机制类似于夏洛特系统中采用的急切调度机制。简单的渴望调度的缺点之一是,如果一个给定的任务导致重复的失败,整个计算无法完成。我们用跳过坏记录的机制修复了这个问题的一些实例。
MapReduce的实现依赖于内部集群管理系统,该系统负责在大量共享机器上分发和运行用户任务。集群管理系统虽然不是本文的重点,但在精神上与Condor等其他系统相似。
排序工具是MapReduce库的一部分,在操作上类似于NOW-Sort。源机器(map worker)对要排序的数据进行分区,并将其发送给R个reduce worker中的一个。每个reduce worker在本地(如果可能的话,在内存中)对其数据进行排序。当然NOW-Sort没有用户自定义的Map和Reduce函数,而这些函数使我们的库具有广泛的适用性。
River提供了一种编程模型,其中进程通过在分布式队列上发送数据来相互通信。与MapReduce一样,River系统即使在异构硬件或系统扰动引入的不均匀性存在的情况下,也试图提供良好的平均情况性能。River通过仔细地调度磁盘和网络传输来实现这一点,以实现平衡的完成时间。mapreduce采用了不同的方法。通过限制编程模型,MapReduce框架能够将问题划分为大量细粒度任务。这些任务在可用的worker上动态调度,以便更快的worker处理更多的任务。受限制的编程模型还允许我们在作业结束时安排任务的冗余执行,这大大减少了存在不一致性(例如缓慢或卡住的工人)的完成时间。
BAD-FS有一个与MapReduce非常不同的编程模型,而且与MapReduce不同的是,它的目标是在广域网上执行工作。然而,有两个基本的相似之处。(1)两个系统都使用冗余执行来恢复故障造成的数据丢失。(2)两个系统都使用位置感知调度来减少在拥挤的网络链路上发送的数据量。
TACC是一种简化高可用性网络业务构建的系统。与MapReduce一样,它依赖于重新执行作为实现容错的机制。
7 总结
MapReduce编程模型已经在Google成功地用于许多不同的目的。我们把这一成功归因于几个原因。首先,该模型易于使用,即使对于没有并行和分布式系统经验的程序员也是如此,因为它隐藏了并行化、容错、局部优化和负载平衡的细节。其次,大量的问题很容易表达为MapReduce计算。例如,MapReduce用于为Google的生产网络搜索服务生成数据,用于排序、数据挖掘、机器学习和许多其他系统。第三,我们已经开发了一个MapReduce的实现,它可以扩展到由数千台机器组成的大型机器集群。该实现有效地利用了这些机器资源,因此适合用于Google遇到的许多大型计算问题。
我们从这项工作中学到了一些东西。首先,限制编程模型使其易于并行化和分布计算,并使此类计算具有容错性。第二,网络带宽是一种稀缺资源。因此,我们系统中的许多优化都以减少通过网络发送的数据量为目标:局域优化允许我们从本地磁盘读取数据,并将中间数据的单个副本写入本地磁盘以节省网络带宽。第三,冗余执行可用于减少慢机的影响,并处理机器故障和数据丢失
A Word Frequency
本节包含一个程序,该程序计算在命令行指定的一组输入文件中每个唯一单词的出现次数。
1 | |