CMU15445-lecture8
第八课:树索引
1 表索引
数据库系统内部可以使用多种不同的数据结构,例如内部元数据、核心数据存储、临时数据结构或表索引。对于可能设计范围扫描查询的表索引,哈希表可能不是最佳选择,因为它本质上是无序的。
表索引是表列子集的副本,它被组织和/或排序以便使用这些属性的子集进行有效访问。因此,DBMS可以对表索引执行查找,以更快地找到某些元组,而不是执行顺序扫描。DBMS确保表和索引的内容始终在逻辑上同步。
每个数据库创建的索引数量之间存在权衡。虽然索引越多查询速度越快,但索引也会占用内存并且需要维护。另外,保持它们同步还存在并发问题。DBMS的工作是找出用于执行查询的最佳索引。
2 B+树
B+树是一种自平衡树数据结构,可保持数据排序并允许在O(log(n))中进行搜索、顺序访问、插入和删除。它针对读取/写入大数据块的面向磁盘的DBMS进行了优化。
几乎每个支持保序索引的现代DBMS都使用B+树。有种特殊的数据结构叫做B-树,但人们也使用该术语来泛指一类数据结构。原始B-Tree和B+Tree之间的主要区别在于B-Tree在所有节点中存储键和值,而B+树仅在叶节点中存储值。现代 B+Tree 实现结合了其他 B-Tree 变体的功能,例如 B 链接树中使用的同级指针。
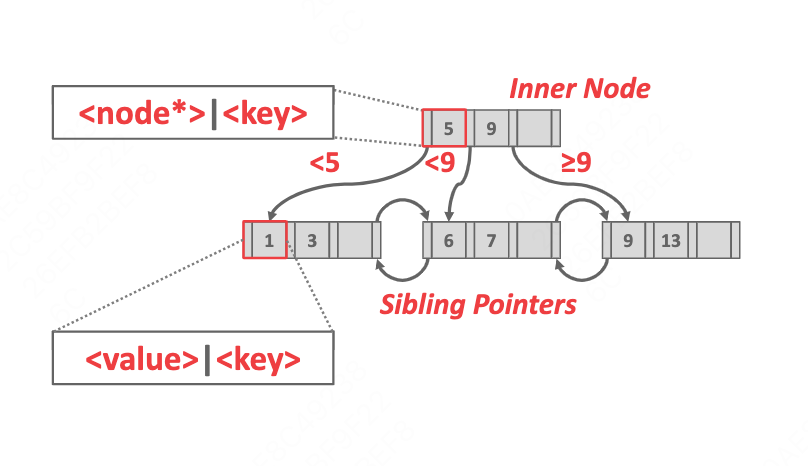
形式上,B+Tree 是一棵 M 路搜索树(其中 M 表示节点可以拥有的子节点的最大数量),具有以下属性:
- 它是完美平衡的(所有叶子结点都是同一个深度)。
- 除根节点外的每个内部节点都至少是半满的(M/2 - 1 <= 键数 <= M-1)。
- 每个有k个键的内部节点有k+1个非空子节点。
B+Tree 中的每个节点都包含一个键/值对数组。
对于叶节点,键是从索引所基于的属性派生的。虽然根据 B+Tree 的定义没有必要,但每个节点的数组几乎总是按键排序。叶节点值的两种方法是记录 ID 和元组数据。记录 ID 是指指向元组位置的指针,通常是主键。具有元组数据的叶节点存储每个节点中元组的实际内容。
对于内部节点,值包含指向其他节点的指针,并且键可以被认为是指南针。它们引导树遍历,但不表示叶节点上的键(以及它们的值)。这意味着您可能在内部节点(作为指南)中有一个在叶节点上找不到的键。尽管必须注意,传统上内部节点仅拥有叶节点中存在的那些键。
根据索引类型(首先为 NULL,最后为 NULL),空键将聚集在第一个叶节点或最后一个叶节点中。
插入
要在 B+Tree 中插入新条目,必须遍历树并使用内部节点来找出要将键插入到哪个叶节点。
- 找到正确的叶子L
按排序顺序将新条目添加到 L 中:
- 如果L有足够空间,则操作完成。
- 否则将叶子分为两个节点L和L2。均匀地重新分配条目并复制中间键。将指向 L2 的条目插入到 L 的父级中。
要分割内部节点,请均匀地重新分配条目,但向上推中间键。
删除
在插入中,当树太满时,我们有时不得不分割叶子,如果删除导致树小于半满,我们必须合并以重新平衡树。
- 找到正确的叶子L
删除条目:
- 如果 L 至少为半满,则操作完成。
- 否则,您可以尝试从兄弟姐妹那里借用来重新分配。
- 如果重新分配失败,则合并 L 和同级。
如果发生合并,则必须删除父项中指向 L 的条目。
选型条件
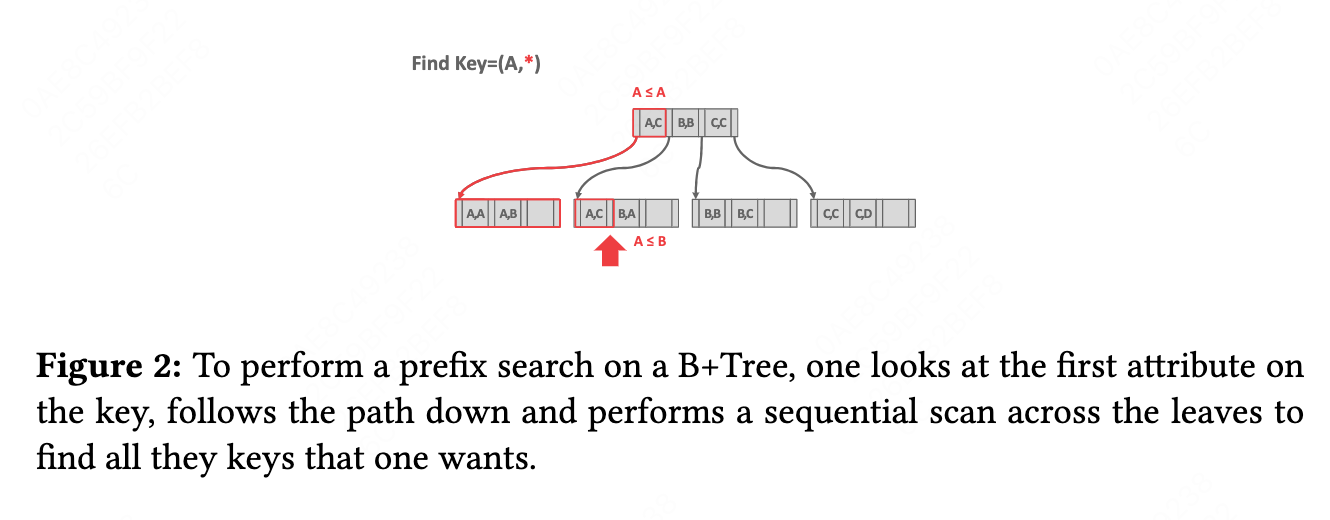
由于 B+Tree 是按顺序排序的,因此查找遍历速度很快,并且不需要整个键。如果查询提供搜索键的任何属性,则 DBMS 可以使用 B+Tree 索引。这与哈希索引不同,哈希索引需要搜索键中的所有属性。
复制键
有两种方法可以在 B+Tree 中复制键。
第一种方法是附加记录 ID 作为键的一部分。由于每个元组的记录 ID 都是唯一的,这将确保所有键都是可识别的。
第二种方法是允许叶节点溢出到包含重复键的溢出节点。虽然没有存储冗余信息,但这种方式维护和修改比较复杂
聚集索引
表按主键指定的排序顺序存储,作为堆或索引组织的存储。由于某些 DBMS 始终使用聚集索引,因此如果表没有显式主键,它们会自动创建隐藏的 row id 主键,但其他 DBMS 根本无法使用它们。
堆聚类
元组按照聚类索引指定的顺序在堆页中排序。如果使用聚簇索引的属性来访问元组,DBMS可以直接跳转到页面。
索引扫描页面排序
由于直接从非聚集索引检索元组效率很低,因此 DBMS 可以首先找出它需要的所有元组,然后根据它们的页 id 对它们进行排序。这样,每个页面只需提取一次。
3 B+树设计选择
3.1 节点大小
根据存储介质的不同,我们可能更喜欢更大或更小的节点大小。例如,存储在硬盘驱动器上的节点的大小通常约为兆字节,以减少查找数据所需的查找次数并分摊读取大量数据所需的昂贵磁盘成本,而内存数据库可能使用小至 512 字节的页面大小,以便将整个页面放入 CPU 缓存并减少数据碎片。这个选择还可以依赖于工作负载的类型。对于点查询而言,它会更喜欢尽可能小的页面,以减少加载不必要的额外信息的数量,而对于大规模顺序扫描而言,它可能更喜欢大页面以减少需要执行的获取次数。
3.2 合并阈值
虽然 B+Tree 有删除后合并下溢节点的规则,但有时暂时违反该规则可能会有益于减少删除操作的次数。例如,急于合并可能会导致抖动,其中大量连续的删除和插入操作会导致不断的拆分和合并。它还允许批量合并,其中多个合并操作同时发生,从而减少了在树上花费昂贵的写入锁存器的时间。
有一些合并策略会保留树中的小节点并在以后重建它,这使得树不平衡(如在 Postgres 中)。我们不会在课上讨论这个问题。
3.3 可变长密钥
目前我们只讨论了具有固定长度键的 B+树。然而,我们可能还希望支持可变长度密钥,例如大密钥的一小部分子集导致大量空间浪费的情况。有几种方法可以做到这一点:
指针
我们可以只存储指向键的指针,而不是直接存储键。
可变长节点
我们还可以像平常一样存储密钥并允许可变长度节点。由于处理可变长度节点的内存管理开销很大,这通常是不可行的并且基本上不被使用。
填充
我们可以将每个键的大小设置为最大键的大小,并填充所有较短的键,而不是改变键的大小。在大多数情况下,这是对内存的巨大浪费,因此也看不到任何人使用它。
键映射/间接
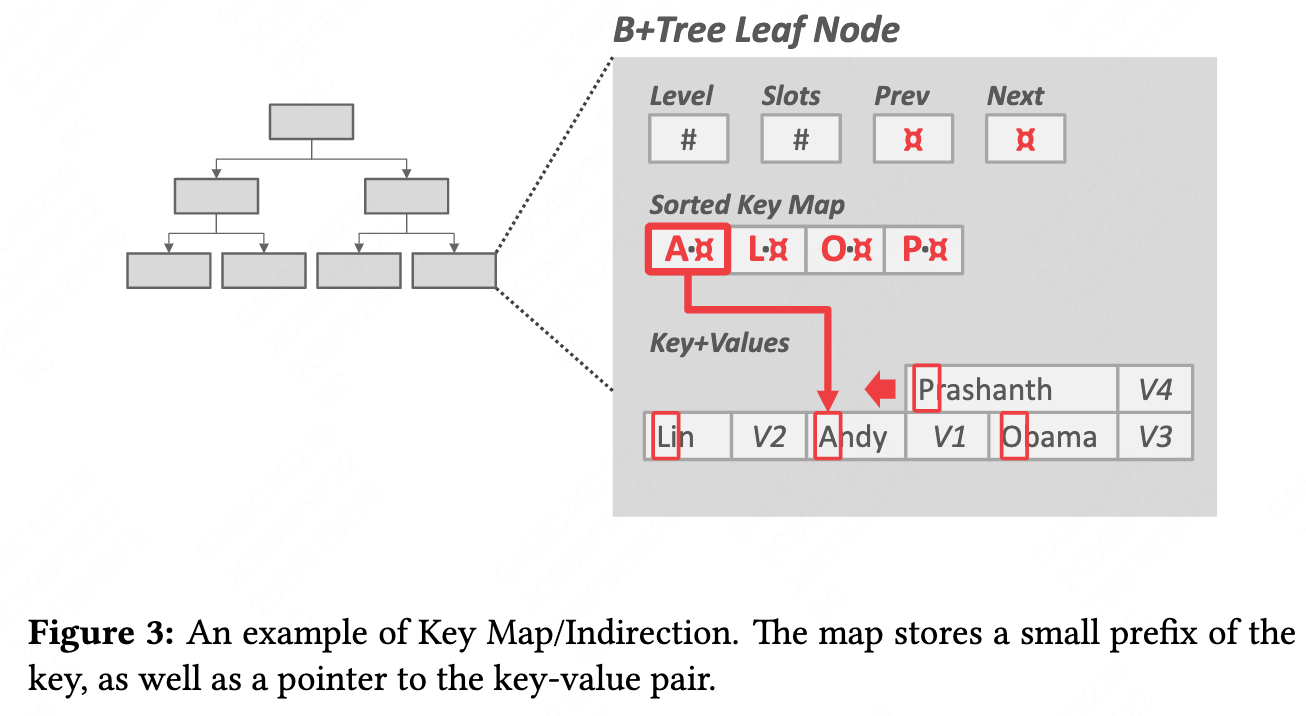
几乎每个人都使用的方法是将键替换为单独字典中键值对的索引。这提供了显着的空间节省和潜在的快捷点查询(因为索引指向的键值对与叶节点指向的键值对完全相同)。由于字典索引值的大小较小,可以在索引的旁边放置每个键的前缀,这样在索引搜索和叶节点扫描时,如果前缀与搜索键不完全相同,可能并不需要追踪指针。
3.4 节点内搜索
一旦我们到达一个节点,我们仍然需要在该节点内搜索(要么从内部节点找到下一个节点,要么在叶节点中找到我们的键值)。虽然这相对简单,但仍然需要考虑一些权衡:
线性
最简单的解决方案是扫描节点中的每个键,直到找到我们的键。一方面,我们不必担心对键进行排序,从而使插入和删除速度更快。另一方面,这是相对低效的,并且每次搜索的复杂度为 O(n)。这可以使用 SIMD(或等效)指令进行矢量化。
二分
更有效的搜索解决方案是保持每个节点排序并使用二分搜索来查找键。这就像跳转到节点中间并根据键之间的比较向左或向右旋转一样简单。这种方式的搜索效率要高得多,因为这种方法每次搜索的复杂度仅为 O(ln(n))。然而,插入变得更加昂贵,因为我们必须维护每个节点的排序。
插值法
这种方式的搜索效率要高得多,因为这种方法每次搜索的复杂度仅为 O(ln(n))。然而,插入变得更加昂贵,因为我们必须维护每个节点的排序。此方法利用存储的有关节点的任何元数据(例如最大元素、最小元素、平均值等),并使用它来生成键的大致位置。例如,如果我们在节点中查找 8,并且我们知道 10 是最大键,10−(n+ 1) 是最小键(其中 n 是每个节点中键的数量),那么我们知道从最大键开始向下搜索 2 个槽,因为在这种情况下,距离最大键 1 个槽的键必须是 9。尽管这是我们给出的最快的方法,但由于它对具有某些属性(如整数)和复杂性的密钥的适用性有限,因此该方法仅在学术数据库中出现。
4 优化
4.1 指针swizzling
因为B+Tree的每个节点都存储在缓冲池中的一个页面中,所以每次加载新页面时,我们都需要从缓冲池中获取它,需要锁存和查找。要完全跳过此步骤,我们可以存储实际的原始指针来代替页面 ID(称为“swizzling”),从而完全防止缓冲池获取。我们可以在正常遍历索引时简单地存储页面查找的结果指针,而不是手动获取整个树并手动放置指针。请注意,我们必须跟踪哪些指针被混合,并在它们指向的页面被取消固定和受害时将它们解调回页面 ID。
4.2 批量插入
当 B+Tree 最初构建时,必须以通常的方式插入每个键将导致不断的分裂操作。由于我们已经给出了叶子同级指针,因此如果我们构造叶节点的排序链表,然后使用每个叶节点的第一个键从下往上轻松构建索引,则数据的初始插入会更有效。请注意,根据我们的上下文,我们可能希望尽可能紧密地包装叶子以节省空间,或者在每个叶子中留出空间,以便在需要分割之前允许更多插入。
4.3 前缀压缩
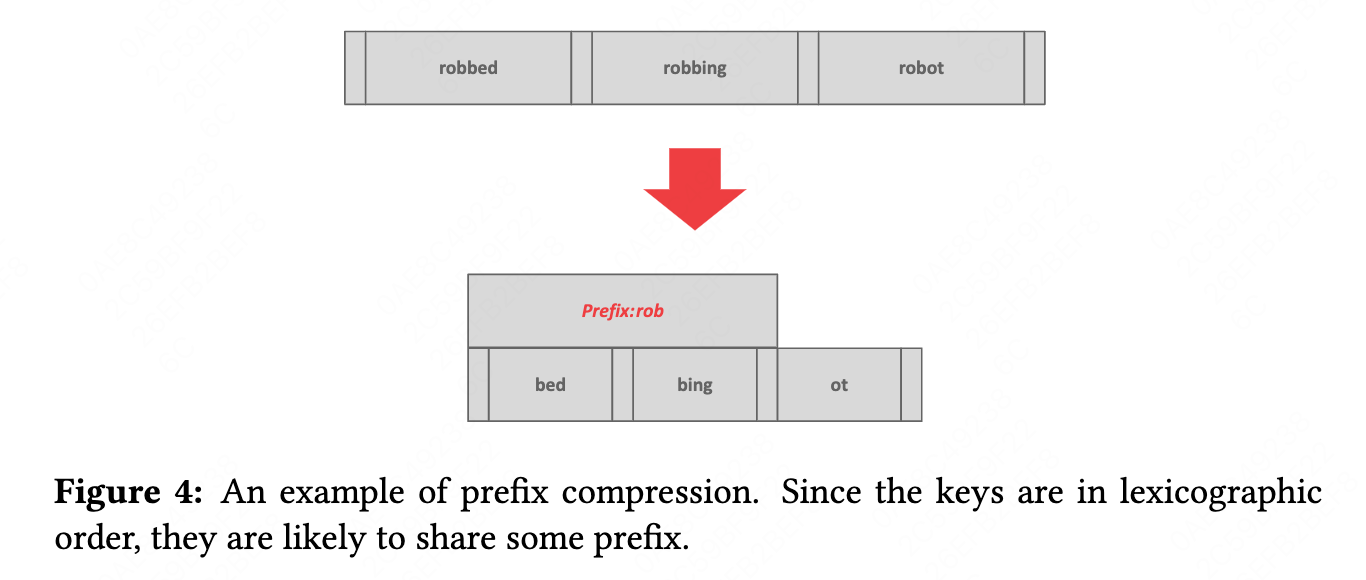
大多数时候,当我们在同一个节点中拥有键时,每个键的某些前缀都会有部分重叠(因为相似的键最终会在排序的 B+Tree 中紧邻彼此)。我们可以简单地将前缀存储在节点的开头一次,然后只在每个槽中包含每个键的唯一部分,而不是多次将此前缀存储为每个键的一部分。
4.4 删除重复数据
在允许非唯一键的索引的情况下,我们最终可能会得到包含相同键并附加不同值的叶节点。对此的一种优化可能是只写入一次密钥,然后在其后面写入所有关联的值。
4.5 后缀截断
大多数情况下,内部节点中的键条目仅用作路标,而不是其实际键值(即使索引中存在某个键,我们仍然必须搜索到底部以确保它没有被删除)。我们可以通过仅存储将探测器正确路由到正确节点所需的最小前缀来利用这一点。
4.6 写入优化的 B+ 树
拆分/合并节点操作的成本很高。因此,B-Tree 的某些变体(例如 Bε-Tree)会记录内部节点中的更改,并稍后将更新向下传播到叶节点。