Bigtable
Bigtable:结构化数据的分布式存储系统
概要
Bigtable是一个用于管理结构化数据的分布式存储系统,旨在扩展到非常大的尺寸:数千台商用服务器上的PB级数据。Google 的许多项目都将数据存储在 Bigtable 中,包括网络索引、Google Earth 和 Google Finance。这些应用程序对 Bigtable 提出了截然不同的要求,无论是在数据大小(从 URL 到网页到卫星图像)还是延迟要求(从后端批量处理到实时数据服务)方面。尽管存在这些不同的需求,Bigtable 仍然成功地为所有这些 Google 产品提供了灵活的高性能解决方案。在本文中,我们描述了 Bigtable 提供的简单数据模型,该模型使客户端能够动态控制数据布局和格式,并描述了 Bigtable 的设计和实现。
1 介绍
在过去的两年半中,我们设计、实现和部署了一个分布式存储系统,用于管理 Google 的结构化数据,称为 Bigtable。Bigtable 旨在可靠地扩展到 PB 级数据和数千台机器。Bigtable 实现了多个目标:广泛适用性、可扩展性、高性能和高可用性。Bigtable 被 60 多个 Google 产品和项目使用,包括 Google Analytics、Google Finance、Orkut、个性化搜索、Writely 和 Google Earth。这些产品将 Bigtable 用于各种要求苛刻的工作负载,从面向吞吐量的批处理作业到向最终用户提供对延迟敏感的数据。这些产品使用的 Bigtable 集群涵盖范围广泛的服务器,从少量到数千台服务器,并存储多达数百 TB 的数据。
在许多方面,Bigtable 类似于一个数据库:它与数据库共享许多实现策略。Parallel 数据库和主内存数据库已经实现了可扩展性和高性能,但 Bigtable 提供了与此类系统不同的接口。Bigtable不支持完整的关系数据模型;相反,它为客户端提供了一个简单的数据模型,支持对数据布局和格式的动态控制,并允许客户端推断底层存储中表示的数据的局部性属性。使用行名和列名(可以是任意字符串)对数据进行索引。Bigtable 还将数据视为未解释的字符串,尽管客户端经常将各种形式的结构化和半结构化数据序列化到这些字符串中。客户可以通过仔细选择其模式来控制数据的位置。最后,Bigtable模式参数允许客户端动态控制是从内存还是从磁盘提供数据。
第 2 节更详细地描述了数据模型,第 3 节提供了客户端 API 的概述。第4节简述了Bigtable所依赖的底层Google基础设施。第5节描述了Bigtable实现的基础知识,第6节描述了我们为提高Bigtable性能所做的一些改进。我们在第 7 节中描述了 Google 如何使用 Bigtable 的几个示例,并在第 8 节中讨论了我们在设计和支持 Bigtable 时学到的一些经验教训。最后,第9节描述了相关工作,第10节介绍了我们的结论。
2 数据模型
Bigtable是一个稀疏的、分布式的、持久的多维排序映射。该映射通过行键、列键和时间戳进行索引;映射中的每个值都是未解释的字节数组。
(row:string, column:string, time:int64) -> string
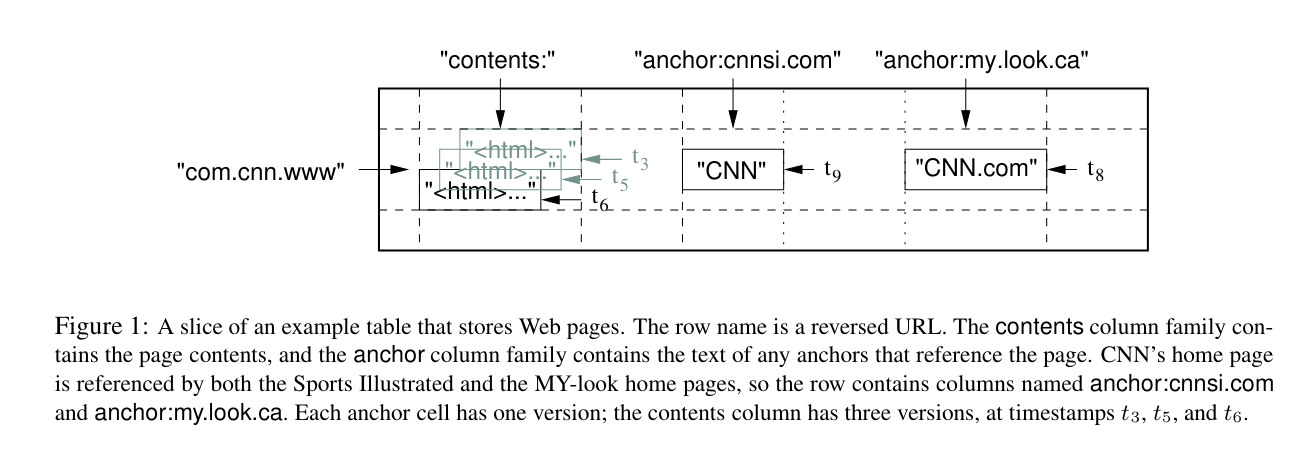
在检查了类似 Bigtable 的系统的各种潜在用途后,我们决定采用这个数据模型。作为推动我们的一些设计决策的一个具体示例,假设我们向阳保留大量网页和相关信息的副本,供许多不同的项目使用;让我们将这个特定的表称为Webtable。在Webtable中,我们将使用URL作为行键,使用网页的各个方面作为列名称,并将网页内容存储在抓取时的时间戳下的contents:column中,如图1所示。
行
在一个表中行键值是任意的字符串(目前最大大小为64kb,尽管10-100字节时我们大多数用户的典型大小)。在单个行键下读取或写入数据的每次都是原子的(无论行中读取或写入的不同列的数量如何),这种设计决策使客户端更容易在同一行存在并发更新的情况下推理系统的行为。
Bigtable按行键的字典顺序维护数据。一个表的行范围是动态分区的。每一个行范围称为一个tablet,它是分配和负载均衡的单位。因此,短行范围的读取是有效的,并且通常只需要与少量机器进行通信。客户端可以通过选择行键来利用此属性,以便获得良好的数据访问局部性。例如,在Webtable中,通过反转URL的主机名部分,同一域中的页面被分组为连续的行。例如,我们将maps.google.com/index.html的数据存储在com.google.maps/index.htm键下。将来自同一域的页面彼此靠近存储可以使某些主机和域分析更加有效。
列族
列键被分组为称为列族的集合,它们构成访问控制的基本单元。存储在了列族中的所有数据通常都是相同的类型(我们将同一列族中的数据压缩在一起)。必须先创建列族,然后才能将数据存储在该族中的任何一个列键下;创建族后,可以使用族内的任何列键。我们的目的是表中不同列族的数量很小(最多数百个),并且列族在操作过程中很少发生变化。相反,表可以具有无限数量的列。
列键使用以下语法命名:family:qualifier。列族名称必须是可打印的,但限定符可以是任意字符串。Webtable的一个示例列族是language,它存储编写网页所用的语言。我们只使用language族中的一个列键,它存储每个网页的语言ID。该表的另一个有用的列族是锚;该族中的每个列键代表一个锚点,如图1所示。限定符是引用站点的名称;单元格内容是链接文本。
访问控制以及磁盘和内存和酸都是在列族级别执行的。在我们Webtable示例中,这些控件使我们能够管理几种不同类型的应用程序:有些添加新的基础数据,有些读取基础数据并创建派生列族,有些只允许查看现有数据(处于隐私原因甚至可能不允许查看所有现有列族)。
时间戳
Bigtable中的每个单元格可以包含相同数据的多个版本;这些版本按时间戳索引。Bigtable时间戳是64位整数。它们可以由 Bigtable 签名,在这种情况下,它们以微秒为单位表示“实时”,也可以由客户端应用程序显式分配。需要避免冲突的应用程序必须自己生成唯一的时间戳。单元的不同版本按时间戳降序存储,以便可以首先读取最新版本。
写入Bigtable
1 | |
为了减轻版本数据的管理负担,我们支持两个每列族设置,告诉Bigtable自动垃圾收集单元版本。客户端可以指定仅保留单元的最后 n 个版本,或者仅保留足够新的版本(例如,仅保留最近 7 天内写入的值)。
在我们的 Webtable 示例中,我们将存储在 content:column中的已爬网页的时间戳设置为实际爬取这些页面版本的时间。上面描述的垃圾回收机制允许我们只保留每个页面的最新三个版本。
3 API
Bigtable API 提供了创建和删除表和列族的功能。它还提供更改集群、表和列族元数据的功能,例如访问控制权限。
客户端应用程序可以在 Bigtable 中写入或删除值、从各个行查找值或迭代表中的数据子集。图 2 显示了使用 RowMutation 抽象来按形式进行一系列更新的 C++ 代码。(省略了不相关的细节,以保持示例简短。对 Apply 的调用对 Webtable 执行原子突变:它向 www.cnn.com 添加一个锚点并删除另一个锚点。
图 3 显示了使用 Scanner 抽象遍历特定行中所有定位点的 C++ 代码。客户端可以遍历多个列族,并且有多种机制可用于限制扫描生成的行、列和时间戳。例如,我们可以将上面的扫描限制为仅生成其列与正则表达式锚点匹配的锚点:*.cnn.com,或者仅生成时间戳落在当前时间十天内的锚点。
从Bigtable读取:
1 | |
Bigtable 支持其他几个功能,允许用户以更复杂的方式操作数据。首先,Bigtable 支持单行事务,可用于对存储在单行键下的数据执行原子读取-修改-写入序列。Bigtable 目前不支持跨行键的一般事务,尽管它提供了一个用于在客户端跨行键批量写入的接口。其次,Bigtable 允许将单元格用作整数计数器。最后,Bigtable 支持在服务器的地址空间中执行客户端提供的脚本。这些脚本是用 Google 开发的一种名为 Sawzall 的数据处理语言编写的。目前,我们基于 Sawzall 的 API 不允许客户端脚本写回 Bigtable,但它允许各种形式的数据转换、基于任意表达式的过滤以及通过各种运算符进行汇总。
Bigtable 可以与 MapReduce 一起使用,MapReduce 是 Google 开发的运行大规模并行计算的框架。我们编写了一组包装器,允许将 Bigtable 用作 MapReduce 作业的输入源和输出目标。
4 建筑模块
Bigtable是建立在Google基础架构的其他几个部分之上的。Bigtable使用分布式Google文件系统(GFS)来存储日志和数据文件。Bigtable集群通常在运行各种其他分布式应用程序的计算机共享池中运行,并且Bigtable进程通常与其他应用程序的进程共享同一台计算机。Bigtable依赖于集群管理系统来调度作业、管理共享机器上的资源、处理机器故障以及监视机器状态。
Google SSTable文件格式在内部使用来存储Bigtable数据。SSTable提供了从键到值的持久的、有序的不可变映射,其中键和值都是任意字节字符串。提供了一些操作来查找与指定键关联的值,并循环访问指定键范围内的所有键/值对。在内部,每个SSTable包含一系列块(通常每个块的大小为64KB,但这是可配置的)。块索引(存储在SSTable的末尾)用于定位块;当SSTable打开时,索引被加载到内存中。可以通过单个磁盘查找来执行查找:我们首先通过在内存索引中执行二分搜索来找到适当的块,然后从磁盘中读取适当的块。或者,SSTable可以完全映射到内存中,这使我们能够在不接触磁盘的情况下执行查找和扫描。
Bigtable依赖于一个名为Chubby的高可用且持久的分布式锁服务。一个Chubby服务由5个活动副本组成,其中一个被选举为主副本并主动服务请求。当大多数副本正在运行并且可以相互通信时,该服务处于活动状态。Chubby使用Paxos算法在出现故障时保持其副本的一致性。Chubby提供了一个由目录和小文件组成的命名空间。每个目录或文件都可以用作锁,并且对文件的读取和写入是原子的。Chubby客户端库提供了Chubby文件的一致缓存。每个Chubby客户端都维护与Chubby服务的会话。如果客户端无法在租约到期时间内续订其会话租约,则客户端的会话将到期。当客户端的会话过期时,它会丢失所有锁和打开的句柄。Chubby客户端还可以在Chubby文件和目录上注册回调,以通知更改或会话过期。
Bigtable使用Chubby执行各种任务:确保在任何时候最多有一个活动主节点;存储 Bigtable 数据的引导位置(参见第 5.1 节);发现tablet服务器并确定tablet服务器死亡(请参阅第 5.2 节);存储 Bigtable 架构信息(每个 table 的列族信息);并存储访问控制列表。如果 Chubby 在很长一段时间内不可用,则 Bigtable 将不可用。我们最近在跨越 11 个 Chubby 实例的 14 个 Bigtable 集群中检验了这种效果。由于 Chubby 不可用(由 Chubby 中断或网络问题引起)而导致存储在 Bigtable 中的某些数据不可用的 Bigtable 服务器时间的平均百分比为 0.0047%。受 Chubby 不可用性影响最大的单个集群的百分比为 0.0326%。
5 实现
Bigtable实现具有三个主要组件:链接到每个客户端的库、一台主服务器和许多tablet服务器。可以从集群中动态添加或删除tablet服务器,以适应工作负载的变化。
master负责将tablet分配给tablet服务器、检测tablet服务器的添加和过期、平衡tablet服务器负载以及GFS中文件的垃圾收集。此外,它还处理架构更改,例如表和列族的创建。
每个tablet服务器管理一组tablet(通常每个tablet服务器有十到一千个tablet)。tablet服务器处理对其已加载到table的读写请求,并且分割内存已经变得太大的tablet。
与许多单主机分布式存储系统一样,客户端数据不通过主机移动:客户端直接与tablet服务器通信以进行读取和写入。由于Bigtable客户端不依赖主服务器获取tablet位置信息,因此大多数客户端从不与主服务器通信。因此,master在实践中的负载很轻。
Bigtable集群存储许多表。每个表由一组tablet组成,每个tablet包含与行范围相关联的所有数据。最初,每个表仅包含一个tablet,随着表的增长,它会自动拆分为多个片,默认情况下每个片的大小约为100-200MB。
5.1 Tablet位置
我们使用类似于B+树的三级层次结构来存储tablet的位置信息(图4)。
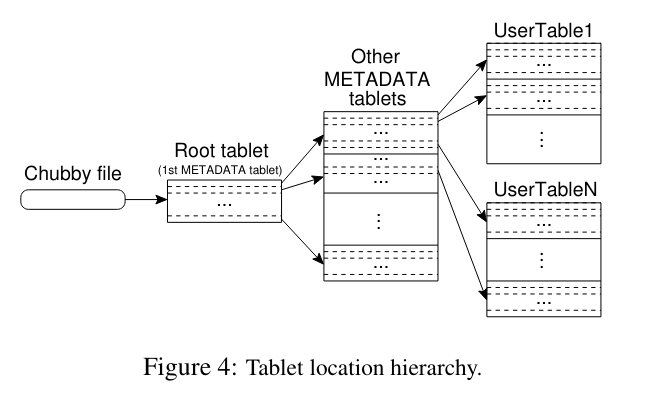
第一层是存储在Chubby中的文件,其中包含根数据块的位置。根tablet包含所有tablet在特殊METADATA表中的位置。每个元数据tablet都包含一组用户tablet的位置。根tablet只是METADATA表中的第一个tablet,但经过特殊处理——它永远不会被分割——以确保tablet位置层次结构不超过三个级别。METADATA 表将tablet的位置存储在行键下,该行键是tablet的表标识符及其结束行的编码。每个METADATA行在内存中存储大约1KB的数据。由于128MB元数据tablet的适度限制,我们的三级定位方案足以寻址234个tablet(或者128MBtablet中的261个字节)。
客户端库缓存tablet位置。如果客户端不知道tablet的位置,或者发现缓存的位置信息不正确,则它会递归地向上移动tablet位置层次结构。如果客户端的缓存为空,则定位算法需要3次网络往返,其中一次从Chubby读取。如果客户端的缓存已过时,则定位算法可能需要最多6次往返,因为过时的缓存条目仅在未命中时才会发现(假设METADATA tablet不经常移动)。尽管tablet位置存储在内存中,因此不需要 GFS 访问,但在常见情况下,我们通过让客户端库预取tablet位置来进一步降低此成本:每当它读取 METADATA 表时,它都会读取多个tablet的元数据。
我们还在元数据表中存储辅助信息,包括与每个tablet相关的所有事件的日志(例如服务器何时开始为其提供服务)。这些信息有助于调试和性能分析。
5.2 tablet分配
每个tablet一次分配给一台tablet服务器。主服务器跟踪一组活动的tablet服务器,以及tbalet到tablet服务器的当前分配,包括哪些tablet未分配。当一个tablet未被分配,并且有足够空间容纳该tablet的tablet服务器可用时,master通过向tablet服务器发送一个tablet加载请求来分配该tablet。
Bigtable 使用 Chubby 来跟踪tablet服务器。当 Tablet 服务器启动时,它会在特定的 Chubby 目录中创建一个唯一命名的文件,并获取该文件的独占锁。主服务器监视此目录(服务器目录)以发现tablet服务器。如果 Tablet 服务器失去其独占锁,则它会停止为其 Tablet 提供服务:例如,由于网络分区导致服务器丢失其 Chubby 会话。(Chubby 提供了一种有效的机制,允许 Tablet 服务器检查它是否仍然持有锁定,而不会产生网络流量。)只要文件仍然存在,tablet 服务器就会尝试重新获取其文件上的独占锁。如果该文件不再存在,那么tablet服务器将永远无法再次提供服务,因此它会自毁进程。每当tablet服务器终止时(例如,因为集群管理系统正在从集群中删除tablet服务器的机器),它会尝试释放其锁,以便主服务器更快地重新分配其tablet。
主服务器负责检测tablet服务器何时不再为其tablet提供服务,并尽快重新分配这些tablet。为了检测某个tablet服务器何时不再为其tablet提供服务,master会定期向每个tablet服务器询问其锁的状态。如果一个tablet服务器报告它已经失去了锁,或者如果主服务器在最后几次尝试期间无法到达服务器,则主服务器会尝试获取服务器文件上的独占锁。如果master能够获取锁,那么Chubby是活的,而tablet服务器要么死了,要么无法到达Chubby,所以master通过删除他的服务器文件来确保tablet服务器永远不会再次提供服务。一旦服务器的文件被删除,master就可以将先前分配给该服务器的所有tablet移动到未分配的tablet组中。为了确保Bigtable集群不会受到master和Chubby之间网络问题的影响,如果Chubby会话过期,master就会自毁。然而,如上述所说,主节点故障不会改变tablet到tablet服务器的分配。
当集群管理系统启动master时,它需要先发现当前的tablet分配,然后才能更改它们。master在启动时执行以下步骤。
- 主节点在Chubby中获取唯一的主锁,这可以防止并发主节点实例化。
- 主服务器扫描Chubby中的服务器目录以查找活动服务器。
- 主服务器与每个活动的tablet服务器进行通信,以发现哪些tablet已分配给每个服务器。
- 主服务器扫描元数据表以了解tablet组。
每当此扫描遇到尚未分配的tablet时,主设备都会将该tablet添加到未分配的tablet集合中,这使得该tablet有资格进行tablet分配。
一个复杂的情况是,在分配METADATA片之前无法扫描METADATA表。因此,在开始扫描(步骤4)之前,如果在步骤3期间未发现根tablet的分配,则主设备会将根tablet添加到未分配的tablet集合中。此添加可确保分配根tablet。因为根tablet包含所有METADATA tablet的名称,所以master在扫描根tablet后就知道所有这些信息。
仅当创建或删除表、合并两个现有tablet以形成一个较大的tablet或将现有tablet拆分为两个较小的tablet时,现有tablet集才会发生变化。主设备能够跟踪这些更改,因为它启动了除最后一个之外的所有更改。tablet拆分会被特殊处理,因为它们是由tablet服务器发起的。tabelt服务器通过在METADATA表中记录新tablet的信息来提交拆分。当拆分提交后,它会通知master。为了防止拆分通知丢失(因为tablet服务器或主节点宕机),当master请求tablet服务器加载现在已经分裂的tablet时,它会检测到新的tablet。tablet服务器将通知master拆分的信息,因为它在元数据表中找到的tablet条目将仅指定master要求其加载的tablet的一部分。
5.3 tablet服务
tablet的持久状态存储在GFS中,如图5所示。更新被提交到存储重做记录的提交日志中。在这些更新中,最近提交的更新存储在内存中一个称为memtable的排序缓冲区中;较旧的更新存储在一系列SSTable中。为了恢复tablet,tablet服务器从 METADATA 表中读取其元数据。
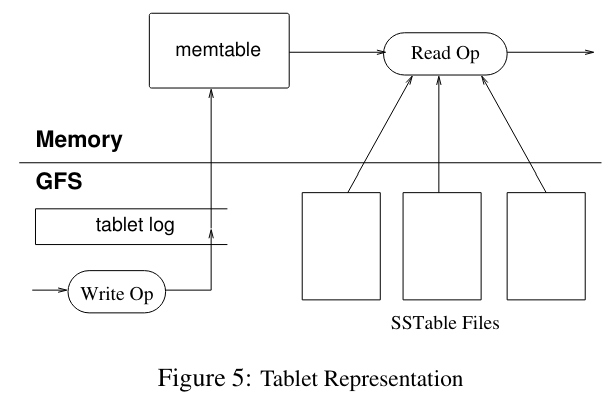
该元数据包含SSTable列表,该列表包含一个tablet和一组重做点,这些重做点是指向可能包含tablet数据的任何提交日志的指针。服务器将SSTable的索引读取到内存中,并通过应用自重做点以来已提交的所有更新来重建内存表。
当写操作到达tablet服务器时,服务器会检查它的格式是否正确,以及发送者是否有权执行突变。授权是通过从Chubby文件(几乎总是在Chubby客户端缓存中命中)读取允许的写入者列表来执行的。有效的变更将写入提交日志。组提交用于提高大量小突变的吞吐量。提交写入后,其内容将插入到内存表中。
当读取操作到达tablet服务器时,同样会检查其格式正确性和正确的授权。在SSTable序列和内存表的合并视图上执行有效的读取操作。由于SSTable和memtable时按字典序排序的数据结构,因此可以有效地形成合并视图。
当tablet被拆分和合并时,传入的读取和写入操作可以继续。
5.4 压缩
随着写操作的执行,内存表的大小会增加。当memtable大小达到阈值时,memtable被冻结,创建新的memtable,并将冻结的memtable转换为SSTable并写入GFS。这个次要压缩过程有两个目标:它减少了tablet服务器的内存使用量,并且减少了如果该服务器挂掉时在恢复期间必须从提交日志中读取的数据量。当压缩发生时,传入的读和写操作可以继续。
每次较小的压缩都会创建一个新的 SSTable。如果这种行为继续不加控制,读取操作可能需要合并来自任意数量的 SSTable 的更新。相反,我们通过在后台定期执行合并压缩来限制此类文件的数量。合并压缩读取几个SSTable和memtable的内容,并写出一个新的SSTable。压缩完成后,输入的SSTable和memtable就可以被丢弃。
将所有SSTable重写为一个SSTable的合并压缩称为主要压缩。非主要压缩生成的SSTable可以包含特殊的删除条目,这些条目会抑制仍然存在的旧SSTable中已删除的数据。另一方面,主要压缩会生成不包含删除信息或已删除数据的SSTable。Bigtable循环遍历其所有tablet,并定期对它们应用主要压缩。这些主要压缩使Bigtable能够回收已删除数据所使用的资源,并确保已删除数据及时从系统中消失,这对于存储敏感数据的服务非常重要。
6 改进
上一节中描述的实现需要进行大量改进才能实现用户所需的高性能、可用性和可靠性。本节更详细地描述了部分实现,以突出这些改进。
位置组
客户端可以将多个列族组合到一个位置组中。为每个tablet中的每个位置组生成一个单独的SSTable。将通常不一起访问的列族分离到单独的位置组中可以实现更高效的读取。例如,Webtable中的页面元数据(例如语言和校验和)可以位于一个位置组中,而页面的内容可以位于不同的组中:想要读取元数据的应用程序不需要读取所有页面内容。
此外,还可以在每个位置组的基础上指定一些有用的优化参数。例如,可以将位置组声明为内存中。内存中位置组的 SSTable 将延迟加载到 Tablet 服务器的内存中。加载后,可以在不访问磁盘的情况下读取属于此类位置组的列名称。此功能对于经常访问的小块数据非常有用:我们在内部将其用于 METADATA 表中的位置列系列。
压缩
客户端可以控制是否压缩位置组的 SSTable,如果是,则使用哪种压缩格式。用户指定的压缩格式应用于每个 SSTable 块(其大小可通过局部组特定调整参数进行控制)。虽然我们通过单独压缩每个块而损失了一些空间,但我们受益于可以读取 SSTable 的一小部分,而无需解压缩整个文件。许多客户端使用两遍自定义压缩方案。第一遍使用 Bentley 和 McIlroy 的方案,该方案在一个大窗口中压缩长的公共字符串。第二遍使用快速压缩算法,在数据的 16 KB 小窗口中查找重复项。两种压缩过程都非常快,在现代机器上,它们的编码速度为 100-200 MB/s,解码速度为 400-1000 MB/s。
尽管我们在选择压缩算法时强调速度而不是空间减少,但这种两遍压缩方案的表现却出奇的好。例如,在Webtable中,我们使用这种压缩方案来存储网页内容。在一项实验中,我们将大量文档存储在压缩的位置组中。出于实验目的,我们将自己限制为每个文档的一个版本,而不是存储我们可用的所有版本。该方案实现了10比1的空间缩减。由于 Webtable 行的布局方式,这比 HTML 页面上典型的 Gzip 压缩(3 比 1 或 4 比 1)要好得多:来自单个主机的所有页面都彼此靠近存储。这允许 Bentley-McIlroy 算法识别来自同一主机的页面中的大量共享样板。许多应用程序(不仅仅是 Webtable)选择它们的行名,以便类似的数据最终聚集起来,从而实现非常好的压缩比。当我们在Bigtable中存储相同值的多个版本时,压缩率会变得更好。
缓存以提高读取性能
为了提高读取性能,tablet服务器使用两个级别的缓存。扫描缓存是一种更高级别的缓存,用于缓存 SSTable 接口返回的键值对到tablet服务器代码。块缓存是一种较低级别的缓存,用于缓存从 GFS 读取的 SSTables 块。扫描缓存对于倾向于重复读取相同数据的应用程序最有用。块缓存对于倾向于读取接近其最近读取的数据(例如,顺序读取或对热行中同一位置组中的不同列的随机读取)的应用程序非常有用。
布隆过滤器
如第 5.3 节所述,读取操作必须从构成tablet状态的所有 SSTable 中读取。如果这些 SSTable 不在内存中,我们最终可能会进行许多磁盘访问。我们通过允许客户端指定应为特定位置组中的 SSTables 创建 Bloom 过滤器来减少访问次数。Bloom lter 允许我们询问 SSTable 是否可能包含指定行/列对的任何数据。对于某些应用程序,用于存储 Bloom 过滤器的少量tablet服务器内存可大大减少读取操作所需的磁盘寻道次数。我们使用 Bloom 过滤器还意味着大多数对不存在的行或列的查找不需要接触磁盘。
提交日志实现
如果我们将每个 tablet 的提交日志保存在一个单独的日志文件中,那么 GFS 中将同时写入大量文件。根据每个 GFS 服务器上的底层文件系统实现,这些写入可能会导致大量磁盘寻求写入不同的物理日志。此外,每个tablet都有单独的日志 les 也会降低组提交优化的有效性,因为组往往会更小。为了解决这些问题,我们将突变附加到每个tablet服务器的单个提交日志中,将不同tablet的突变混合在同一物理日志中。
在正常操作期间使用一个日志可以提供显著的性能优势,但它会使恢复变得复杂。当一个tablet服务器挂掉时,它所服务的tablet将被转移到大量其他tablet服务器上:每个服务器通常加载少量原始服务器的tablet。为了恢复tablet的状态,新的tablet服务器需要从原始tablet服务器写入的提交日志中重新应用该tablet的突变。然而,这些tablet的突变混合在同一个物理日志文件中。一种方法是让每个新的tablet服务器读取此完整的提交日志,并仅应用它需要恢复的tablet所需的条目。但是,在这种方案下,如果 100 台计算机从发生故障的tablet服务器中为每台计算机分配一台tablet,则日志文件将被读取 100 次(每台服务器读取一次)。
我们通过首先按键<表,行名,日志序列号>的顺序对提交日志条目进行排序来避免重复读取日志。在排序的输出中,特定tablet的所有突变都是连续的,因此可以通过一次磁盘查找和顺序读取来有效地读取。为了并行排序,我们将日志文件划分为64MB的段,并在不同的Tablet服务器上并行对每个段进行排序。此排序过程由主服务器协调,并在Tablet服务器指示它需要从某些提交日志文件中恢复突变时启动。
将提交日志写入 GFS 有时会导致性能中断,原因有多种(例如,写入崩溃时涉及的 GFS 服务器计算机,或者为到达特定的三台 GFS 服务器而遍历的网络路径遭受网络拥塞,或者负载过重)。为了保护突变免受 GFS 延迟峰值的影响,每个 Tablet 服务器实际上有两个日志写入线程,每个线程写入自己的日志文件;一次只有这两个线程之一处于活动状态。如果对活动日志文件的写入性能不佳,则日志文件写入将切换到另一个线程,并且提交日志队列中的突变将由新的活动日志写入线程写入。日志条目包含序列号,以允许恢复过程消除由该日志切换过程产生的重复条目。
加速tablet恢复
如果主服务器将一个tablet从一个tablet服务器移动到另一个tablet服务器,则源tablet服务器首先对该tablet进行次要压缩。这种压缩通过减少tablet服务器提交日志中未压缩状态的数量来减少恢复时间。关闭此操作后,tablet服务器将停止为tablet提供服务。在实际卸载tablet之前,tablet服务器会执行其他(通常非常快)的次要压缩,以消除在执行第一次小型压缩时到达的tablet服务器日志中任何剩余的未压缩状态。在第二次较小的压缩完成后,该tablet可以加载到另一个tablet服务器上,而不需要恢复任何日志条目。
利用不变性
除了SSTable缓存之外,我们生成的所有SSTable都是不可变的,这一事实也简化了Bigtbale系统的各个其他部分。例如,从 SSTable 读取时,我们不需要对文件系统的访问进行任何同步。因此,可以非常有效地实现行的并发控制。唯一可通过读取和写入访问的可变数据结构是内存表。为了减少读取内存表期间的争用,我们使每个内存表行进行写时复制,并允许读取和写入并行进行。
由于 SSTable 是不可变的,永久删除已删除数据的问题就转化为垃圾收集过时的 SSTable。每个tablet的SSTables都注册在METADATA表中。主节点删除过时的 SSTable,作为 SSTable 集合上的标记和清除垃圾收集,其中 METADATA 表包含根集合。
最后,SSTables 的不变性使我们能够快速拆分平板电脑。我们让子tablet 共享父tablet 的SSTable,而不是为每个子tablet 生成一组新的SSTable。
7 经验教训
在设计、实现、维护和支持Bigtable的过程中,我们获得了有用的经验,并学到了一些有趣的教训。
我们学到的一个教训是,大型分布式系统容易遭受多种类型的故障,而不仅仅是许多分布式协议中所设想的标准网络分区和故障停止故障。例如,我们已经见到由于下列原因造成的问题:内存和网络损坏,大时钟偏差,挂机,扩展和对称网络分区,使用其他系统中的错误(比如Chubby),GFS配额溢出,以及计划内和计划外的硬件维护。随着我们在解决这些问题方面获得了更多经验,我们通过更改各种协议来解决这些问题。例如,我们向我们的RPC机制添加了校验和。我们还通过删除系统的一部分对另一部分所做的假设来处理一些问题。例如,我们不再假设给定的 Chubby 操作只能返回一组固定错误中的一个。
我们学到的另一个教训是,在明确如何使用新功能之前,推迟添加新功能非常重要。例如,我们最初计划在 API 中支持通用交易。因为我们没有立即使用它们,无论如何,我们没有实施它们。现在,我们在 Bigtable 上运行了许多实际应用程序,我们已经能够检查它们的实际需求,并且已经发现大多数应用程序只需要单行反转操作。当人们要求分布式交易时,最重要的用途是维护二级索引,我们计划添加专门的机制来满足这一需求。新机制将不如分布式事务那么通用,但会更高效(特别是对于跨越数百行或更多行的更新),并且还将与我们的乐观跨数据中心复制方案更好地交互。
我们从支持 Bigtable 中学到的一个实际教训是适当的系统级监控的重要性(即监控 Bigtable 本身以及使用 Bigtable 的客户端进程)。例如,我们扩展了 RPC 系统,以便对于 RPC 样本,它可以保留代表该 RPC 执行的重要操作的详细跟踪。此功能使我们能够检测和解决许多问题,例如 Tablet 数据结构上的锁争用、提交 Bigtable 突变时向 GFS 写入缓慢,以及当 METADATA Tablet 不可用时对 METADATA 表的访问卡住。另一个有用的监控示例是,每个 Bigtable 集群都在 Chubby 中注册。这使我们能够跟踪所有集群,发现它们有多大,查看它们正在运行的软件版本,它们接收了多少传输,以及是否存在任何问题,例如意外的大延迟。
我们学到的最重要的一课是简单设计的价值。考虑到我们系统的规模(大约 100,000 行非测试代码),以及代码随着时间的推移以意想不到的方式演变的事实,我们发现代码和设计的清晰度对代码维护和调试有很大帮助。其中一项检查是我们的平板电脑-服务器会员协议。我们的第一个协议很简单:主服务器定期向平板电脑服务器发出租约,如果他们的租约到期,平板电脑服务器就会杀死他们自己。不幸的是,在存在网络问题的情况下,这种原型会显著降低可用性,并且对主重新存储时间也很敏感。我们多次重新设计协议,直到我们有一个表现良好的协议。然而,最终的协议过于复杂,并且依赖于其他应用程序很少使用的 Chubby 功能的行为。我们发现我们花费了大量的时间来调试模糊的极端情况,不仅在 Bigtable 代码中,而且在 Chubby 代码中也是如此。最终,我们放弃了这个协议,转而采用一个更新的、更简单的协议,该协议仅依赖于广泛使用的 Chubby 功能。
8 相关工作
Boxwood 项目的组件在某些方面与 Chubby、GFS 和 Bigtable 重叠,因为它提供了分布式协议、锁定、分布式块存储和分布式 B 树存储。在每种有重叠的情况下,Box-wood 的组件似乎都比相应的 Google 服务低一些。Boxwood 项目的目标是为构建更高级别的服务(如文件系统或数据库)提供基础设施,而 Bigtable 的目标是直接支持希望存储数据的客户端应用程序。
最近的许多项目都解决了在广域网上提供分布式存储或更高级别的服务的问题,通常是在“互联网”规模上。这些系统解决了 Bigtable 不会出现的问题,例如高度可变的带宽、不受信任的参与者或频繁的重新协调;去中心化控制和拜占庭式容错不是 Bigtable 的目标。
就可能提供给应用程序开发人员的分布式数据存储模型而言,我们认为分布式 B 树或分布式哈希表提供的键值对模型过于局限。键值对是一个有用的构建块,但它们不应该是提供给开发人员的唯一构建块。我们选择的模型比简单的键值对更丰富,并且支持稀疏的半结构化数据。尽管如此,它仍然足够简单,以至于它适合于非常有效的平面文件表示,并且它足够透明(通过位置组),允许我们的用户调整系统的重要行为。
一些数据库供应商已经开发了可以存储大量数据的并行数据库。Oracle 的 Real Application Cluster 数据库 [27] 使用共享磁盘来存储数据(Bigtable 使用 GFS)和分布式锁管理器(Bigtable 使用 Chubby)。IBM 的 DB2 Parallel Edition [4] 基于类似于 Bigtable 的无共享 [33] 架构。每个 DB2 服务器负责表中行的子集,该行存储在本地关系数据库中。这两种产品都提供了一个完整的事务关系模型。
对于使用基于列而不是基于行的存储在磁盘上组织数据的其他系统,包括 C-Store [1, 34] 和商业产品,如 Sybase IQ [15, 36]、SenSage [31]、KDB+ [22] 和 MonetDB/X100 中的 ColumnBM 存储层 [38],Bigtable 局部组实现了类似的压缩和磁盘读取性能。另一个将垂直和水平数据划分为atles并实现良好数据压缩比的系统是AT&T的Day-tona数据库[19]。局部组不支持 CPU 缓存级别的优化,例如 Ailamaki [2] 所描述的优化。
Bigtable 使用 memtables 和 SSTables 来存储平板电脑更新的方式类似于日志结构化合并树 [26] 存储更新以索引数据的方式。在这两种系统中,排序后的数据在写入磁盘之前都会在内存中缓冲,并且读取必须合并内存和磁盘中的数据。
C-Store 和 Bigtable 有许多共同的特点:这两个系统都使用无共享架构,并具有两种不同的数据结构,一种用于存储最近的写入,另一种用于存储长期数据,并具有将数据从一种形式移动到另一种形式的机制。这些系统在其 API 中存在显着差异:C-Store 的行为类似于关系数据库,而 Bigtable 提供较低级别的读写接口,旨在支持每台服务器每秒数千次此类操作。C-Store 也是一个“读取优化的关系 DBMS”,而 Bigtable 在读取密集型和写入密集型应用程序上都提供了良好的性能。
Bigtable 的负载均衡器必须解决一些与无共享数据库相同的负载和内存平衡问题(例如,[11, 35])。我们的问题稍微简单一些:(1)我们没有考虑同一数据的多个副本的可能性,由于视图或索引,可能以不同的形式出现;(2)我们让用户告诉我们哪些数据属于内存,哪些数据应该保留在磁盘上,而不是试图动态地确定这一点;(3)我们没有复杂的查询来执行或优化。
9 总结
我们已经描述了 Bigtable,这是一个用于在 Google 存储结构化数据的分布式系统。Bigtable 集群自 2005 年 4 月以来一直在生产中使用,在此之前,我们花了大约 7 个人年的时间进行设计和实施。截至 2006 年 8 月,已有 60 多个项目在使用 Bigtable。我们的用户喜欢 Bigtable 组件提供的性能和高可用性,并且随着资源需求的变化,他们只需向系统添加更多计算机即可扩展集群的容量。
鉴于 Bigtable 的不寻常界面,一个有趣的问题是我们的用户适应使用它的难度有多大。新用户有时不确定如何最好地使用 Bigtable 界面,特别是如果他们习惯于使用支持通用事务的关系数据库。尽管如此,许多 Google 产品成功使用 Bigtable 的事实表明,我们的设计在实践中运行良好。
我们正在实现一些附加的 Bigtable 功能,例如支持二级索引和基础设施,用于构建具有多个主副本的跨数据中心复制的 Bigtable。我们还开始将 Bigtable 作为服务部署到 产品组,这样各个组就不需要维护自己的集群。随着服务集群的扩展,我们将需要在 Bigtable 内部处理更多的资源共享问题 [3, 5]。
最后,我们发现在 Google 构建我们自己的存储解决方案具有重要的优势。我们从为 Bigtable 设计自己的数据模型中获得了大量的灵活性。此外,我们对 Bigtable 的实施以及 Bigtable 所依赖的其他 Google 基础设施的控制意味着我们可以在出现瓶颈和缺陷时消除它们。
引用
[1] ABADI, D. J., MADDEN, S. R., AND FERREIRA,
M. C. Integrating compression and execution in column-
oriented database systems. Proc. of SIGMOD (2006).
[2] AILAMAKI, A., DEWITT, D. J., HILL, M. D., AND SK-
OUNAKIS, M. Weaving relations for cache performance.
In The VLDB Journal (2001), pp. 169ñ180.
[3] BANGA, G., DRUSCHEL, P., AND MOGUL, J. C. Re-
source containers: A new facility for resource manage-
ment in server systems. In Proc. of the 3rd OSDI (Feb.
1999), pp. 45ñ58.
[4] BARU, C. K., FECTEAU, G., GOYAL, A., HSIAO,
H., JHINGRAN, A., PADMANABHAN, S., COPELAND,
G. P., AND WILSON, W. G. DB2 parallel edition. IBM
Systems Journal 34, 2 (1995), 292ñ322.
[5] BAVIER, A., BOWMAN, M., CHUN, B., CULLER, D.,
KARLIN, S., PETERSON, L., ROSCOE, T., SPALINK, T.,
AND WAWRZONIAK, M. Operating system support for
planetary-scalenetworkservices. InProc.of the1stNSDI
(Mar. 2004), pp. 253ñ266.
[6] BENTLEY, J. L., AND MCILROY, M. D. Data compres-
sion using long common strings. In Data Compression
Conference (1999), pp. 287ñ295.
[7] BLOOM, B. H. Space/timetrade-offs inhashcodingwith
allowable errors. CACM 13, 7 (1970), 422ñ426.
[8] BURROWS, M. The Chubby lock service for loosely-
coupled distributed systems. In Proc. of the 7th OSDI
(Nov. 2006).
[9] CHANDRA, T., GRIESEMER, R., AND REDSTONE, J.
Paxos made live ó An engineering perspective. In Proc.
of PODC (2007).
[10] COMER, D. Ubiquitous B-tree. Computing Surveys 11, 2
(June 1979), 121ñ137.
[11] COPELAND, G. P., ALEXANDER, W., BOUGHTER,
E. E., AND KELLER, T. W. Dataplacement in Bubba. In
Proc. of SIGMOD (1988), pp. 99ñ108.
[12] DEAN, J., AND GHEMAWAT, S. MapReduce: Simplied
dataprocessingonlargeclusters. InProc.of the6thOSDI
(Dec. 2004), pp. 137ñ150.
[13] DEWITT, D., KATZ, R., OLKEN, F., SHAPIRO, L.,
STONEBRAKER, M., AND WOOD, D. Implementation
techniques for main memory database systems. In Proc.
of SIGMOD (June 1984), pp. 1ñ8.
[14] DEWITT, D. J., AND GRAY, J. Parallel database sys-
tems: The future of high performance database systems.
CACM 35, 6 (June 1992), 85ñ98.
[15] FRENCH, C. D. One size ts all database architectures
do not work for DSS. In Proc. of SIGMOD (May 1995),
pp. 449ñ450.
[16] GAWLICK, D., AND KINKADE, D. Varieties of concur-
rency controlin IMS/VSfastpath. Database Engineering
Bulletin 8, 2 (1985), 3ñ10.
[17] GHEMAWAT, S., GOBIOFF, H., AND LEUNG, S.-T. The
Googlelesystem. InProc.of the19thACMSOSP(Dec.
2003), pp. 29ñ43.
[18] GRAY, J. Notes on database operating systems. In Oper-
ating Systems ó An Advanced Course, vol. 60 of Lecture
Notes in Computer Science. Springer-Verlag, 1978.
[19] GREER, R. Daytona and the fourth-generation language
Cymbal. In Proc. of SIGMOD (1999), pp. 525ñ526.
[20] HAGMANN, R. Reimplementing the Cedar le system
using logging and group commit. In Proc. of the 11th
SOSP (Dec. 1987), pp. 155ñ162.
[21] HARTMAN, J. H., AND OUSTERHOUT, J. K. The Zebra
striped network le system. In Proc. of the 14th SOSP
(Asheville, NC, 1993), pp. 29ñ43.
[22] KX.COM. kx.com/products/database.php. Product page.
[23] LAMPORT, L. The part-time parliament. ACM TOCS 16,
2 (1998), 133ñ169.
[24] MACCORMICK, J., MURPHY, N., NAJORK, M.,
THEKKATH, C. A., AND ZHOU, L. Boxwood: Abstrac-
tionsasthefoundation forstorage infrastructure. InProc.
of the 6th OSDI (Dec. 2004), pp. 105ñ120.
[25] MCCARTHY, J. Recursive functions of symbolic expres-
sionsandtheircomputationbymachine. CACM3, 4 (Apr.
1960), 184ñ195.
[26] O’NEIL, P., CHENG, E., GAWLICK, D., AND O’NEIL,
E. The log-structured merge-tree (LSM-tree). Acta Inf.
33, 4 (1996), 351ñ385.
[27] ORACLE.COM. www.oracle.com/technology/products/-
database/clustering/index.html. Product page.
[28] PIKE, R., DORWARD, S., GRIESEMER, R., AND QUIN-
LAN, S. Interpreting the data: Parallel analysis with
Sawzall. Scientic Programming Journal 13, 4 (2005),
227ñ298.
[29] RATNASAMY, S., FRANCIS, P., HANDLEY, M., KARP,
R., AND SHENKER, S. A scalable content-addressable
network. In Proc. of SIGCOMM (Aug. 2001), pp. 161ñ
[30] ROWSTRON, A., AND DRUSCHEL, P. Pastry: Scal-
able, distributed object location and routing for large-
scale peer-to-peer systems. In Proc. of Middleware 2001
(Nov. 2001), pp. 329ñ350.
[31] SENSAGE.COM. sensage.com/products-sensage.htm.
Product page.
[32] STOICA, I., MORRIS, R., KARGER, D., KAASHOEK,
M. F., AND BALAKRISHNAN, H. Chord: A scalable
peer-to-peer lookup service for Internet applications. In
Proc. of SIGCOMM (Aug. 2001), pp. 149ñ160.
[33] STONEBRAKER, M. The case for shared nothing.
Database Engineering Bulletin 9, 1 (Mar. 1986), 4ñ9.
[34] STONEBRAKER, M., ABADI, D. J., BATKIN, A., CHEN,
X., CHERNIACK, M., FERREIRA, M., LAU, E., LIN,
A., MADDEN, S., O’NEIL, E., O’NEIL, P., RASIN,
A., TRAN, N., AND ZDONIK, S. C-Store: A column-
oriented DBMS. InProc.ofVLDB(Aug.2005), pp. 553ñ
[35] STONEBRAKER, M., AOKI, P. M., DEVINE, R.,
LITWIN, W., AND OLSON, M. A. Mariposa: A new ar-
chitecturefordistributeddata. InProc.oftheTenthICDE
(1994), IEEEComputer Society, pp. 54ñ65.
[36] SYBASE.COM. www.sybase.com/products/database-
servers/sybaseiq. Product page.
[37] ZHAO, B. Y., KUBIATOWICZ, J., AND JOSEPH, A. D.
Tapestry: An infrastructure for fault-tolerant wide-area
location and routing. Tech. Rep. UCB/CSD-01-1141, CS
Division, UC Berkeley, Apr. 2001.
[38] ZUKOWSKI, M., BONCZ, P. A., NES, N., AND HEMAN,
S. MonetDB/X100 óA DBMSin the CPUcache. IEEE
Data Eng. Bull. 28, 2 (2005), 17ñ22.