19th-March
面经
刚好都是字节国际电商? 估计问的就差不多,所以偷一下看看
OS
虚拟内存相关
内存虚拟化是什么,有什么目的?
内存虚拟化是一种将物理内存资源抽象、管理和分配的技术。它允许将计算机的物理内存划分为独立的、隔离的虚拟内存块,每个虚拟内存块都有操作系统或虚拟机管理。内存虚拟化可以在多个层次实现,如硬件层、操作系统层或应用程序层。
目的:
- 资源隔离与共享:内存虚拟化可以在不同的进程、应用程序或虚拟机之间隔离内存资源,从而提高系统的稳定性和安全性。同时,内存虚拟化还支持灵活地共享内存资源,以实现负载均衡和资源利用率最大化。
- 易用性:内存虚拟化简化了内存管理,使得程序员无需关注物理内存的具体细节。程序员可以专注于编写代码,而操作系统和硬件负责处理内存分配、回收等问题。
- 容错和回复:内存虚拟化有助于实现容错和故障恢复。当系统发生故障时,可以将虚拟内存的状态保存到磁盘上,然后再另一台计算机上恢复虚拟内存状态,以实现快速恢复(没太懂?)
- 内存优化:内存虚拟化支持一些内存优化技术,如按需分配、内存去重和内存压缩。这些技术可以提高内存资源的利用率,降低内存成本。
- 进程保护:每个进程都有自己的虚拟地址空间,这样就能防止一个进程意外或恶意的访问另一个进程的内存。提高系统的稳定性和安全性。
物理内存与虚拟内存的映射机制
物理内存和虚拟内存的映射机制是计算机系统中实现内存虚拟化的关键技术。虚拟内存到物理内存的映射方式一般有分段和分页两种,由于分段机制内存碎片较多,常用的是分页机制。映射过程有内存管理单元(MMU)和操作系统共同完成。
- 分页机制:在分页系统中,虚拟内存和物理内存都被划分为固定大小的单元,称为页。虚拟页的大小和物理页相同,通常为4KB或更大。分页系统的主要目的是将虚拟内存中的页映射到物理内存中的页。
- 页表:页表是一种数据结构,用于存储虚拟页到物理页的映射关系。每个进程都有自己的页表,由操作系统管理。页表中的每个条目包含一个虚拟页号和对应的物理页号。当CPU访问虚拟内存时,MMU会使用页表将虚拟地址转换为物理地址。
地址转换:虚拟地址通常由两部分组成:虚拟页号(VPN)和页内偏移(offset)。虚拟页号用于查找页表中相应的物理页号,而页内偏移表示在物理页中的具体位置。地址抓换过程如下:
- CPU生成一个虚拟地址
- MMU从虚拟地址中提取虚拟页号和页内偏移
- MMU使用VPN在页表中查找对应的物理页号(PPN)
- MMU将物理页号与页内偏移组合成物理地址
- CPU使用物理地址访问物理内存
页面置换和缺页中断:当虚拟页尚未加载到物理内存时,发生页面缺失(page fault)。在这种情况下,操作系统需要从磁盘或其他存储设备中加载所需的虚拟页,并将其映射到物理内存。为了腾出空间,操作系统可能需要选择一个已加载的页面,将其换出到磁盘。页面置换算法用于决定哪个页面应该被换出
- 多级页表:多级页表使一种用于减少页表大小的技术。在具有大量虚拟地址空间的系统中,使用单级页表可能导致浪费大量内存。多级页表通过将虚拟地址空间划分为多个层次来减小页表的大小。每个层次都有自己的页表,只有在需要时才会分配。这样可以大大减小内存开销。
- 快表(TLB):快表,也称为转换后援缓冲(Translation Lookaside Buffer),是一种硬件缓存,用于加速虚拟地址到物理地址的转换过程。TLB将最近使用过的虚拟地址到物理地址的映射存储在高速缓存中,以便快速查找。当MMU需要转换一个虚拟地址时,它首先检查TLB是否包含所需的映射。如何TLB中存在映射,MMU可以避免访问内存中的页表,从而加速地址转换过程。
- 内存分配策略:操作系统使用不同的内存分配策略来管理虚拟内存和物理内存之间的映射。按需分配是一种常用的策略,它旨在进程实际访问虚拟内存时才将虚拟页加载到物理内存。预取是另一种策略,它根据进程的访问模式提前加载可能需要的虚拟页,以减少页面缺失的开销。
- 内存共享:内存共享是一种允许多个进程访问相同物理内存区域的技术。通过将不同 进程的虚拟地址映射到同一物理页,操作系统可以实现内存共享。这种技术在共享库、进程间通信和内存去重等场景中非常有用。
物理内存和虚拟内存的映射机制通过分页、页表、地址转换、多级页表、TLB、内存分配策略等技术实现。这种映射提供了内存虚拟化、进程隔离和内存优化等关键功能。
进程
进程、线程、协程区别与联系
进程、线程和协程是计算机程序执行的三个不同层次
进程:进程是操作系统进行资源分配和调度的基本单位,是一个独立运行的程序实体。每个进程拥有独立的内存空间、文件描述符、寄存器状态等资源。进程之间的资源是相互隔离的,因此进程间通信需要通过操作系统提供的特定机制(如管道、消息队列、共享内存等)进行。由于进程拥有独立的资源,所以进程间的切换调度开销较大
线程:线程是操作系统调度执行的最小单位,是进程内的一个执行流。一个进程可以拥有多个线程,这些线程共享进程的资源(如内存空间、文件描述符等)。由于线程共享相同的资源,线程间通信相对简单,可以直接通过共享变量、锁等方式进行。线程相较于进程,上下文切换和调度开销较小。但多个线程并行执行时,需要处理好同步和互斥问题,以避免数据不一致或竞争条件。
协程:协程是一种用户态的轻量级线程,它的调度和切换完全由程序控制,不依赖于操作系统的调度。协程之间共享线程的资源,因此协程间通信也可以通过共享变量、锁等方式进行。协程的优势在于可以轻松地实现高并发,因此协程切换和调度的开销非常小。协程适用于I/O密集型任务,通过异步I/O可以有效地提高程序的性能。
联系
- 线程属于进程,多个线程共享进程的资源,一个进程可以包含多个线程,这些线程共同完成任务,提高程序的并发性。
- 协程属于线程,多个协程共享线程的资源。一个线程可以包含多个协程,这些协程共同完成任务,提高程序的并发性。
- 进程、线程和协程在执行程序时,都需要面对异步、互斥和通信等问题。在实际应用中,可以根据需求和场景选择合适的执行实体来实现最优的性能和资源利用。
计网
TCP的确认机制
1.确认的作用
TCP的确认机制用于确保数据的可靠传输。当接收端成功接收到一个数据包时,它会返回一个确认信号(ACK)给发送端。这个确认信号包含了接收端期望接受的下一个数据包的序号。发送端收到确认信号后,就知道之前发送的数据包已经被成功接收,并可以继续发送后续的数据包。
2.确认的实现方式
确认信号是通过TCP数据包中的ACK标志位来实现。当ACK标志位被设置为1时,表示该数据包时一个确认信号。确认信号中还包含一个32位的确认号字段,用于指示接收端期望接受的下一个数据包的序号。
TCP流量控制
发送方不能无脑的发数据给接收方,要考虑接收方处理能力。
如果一直无脑的发数据给对方,但对方处理不过来,那么就会导致触发重发机制,从而导致网络流量的无端的浪费。
为了解决这种现象发生,TCP提供了一种机制可以让发送放根据接收方的实际接受能力控制发送的数据量,这就是所谓的流量控制。
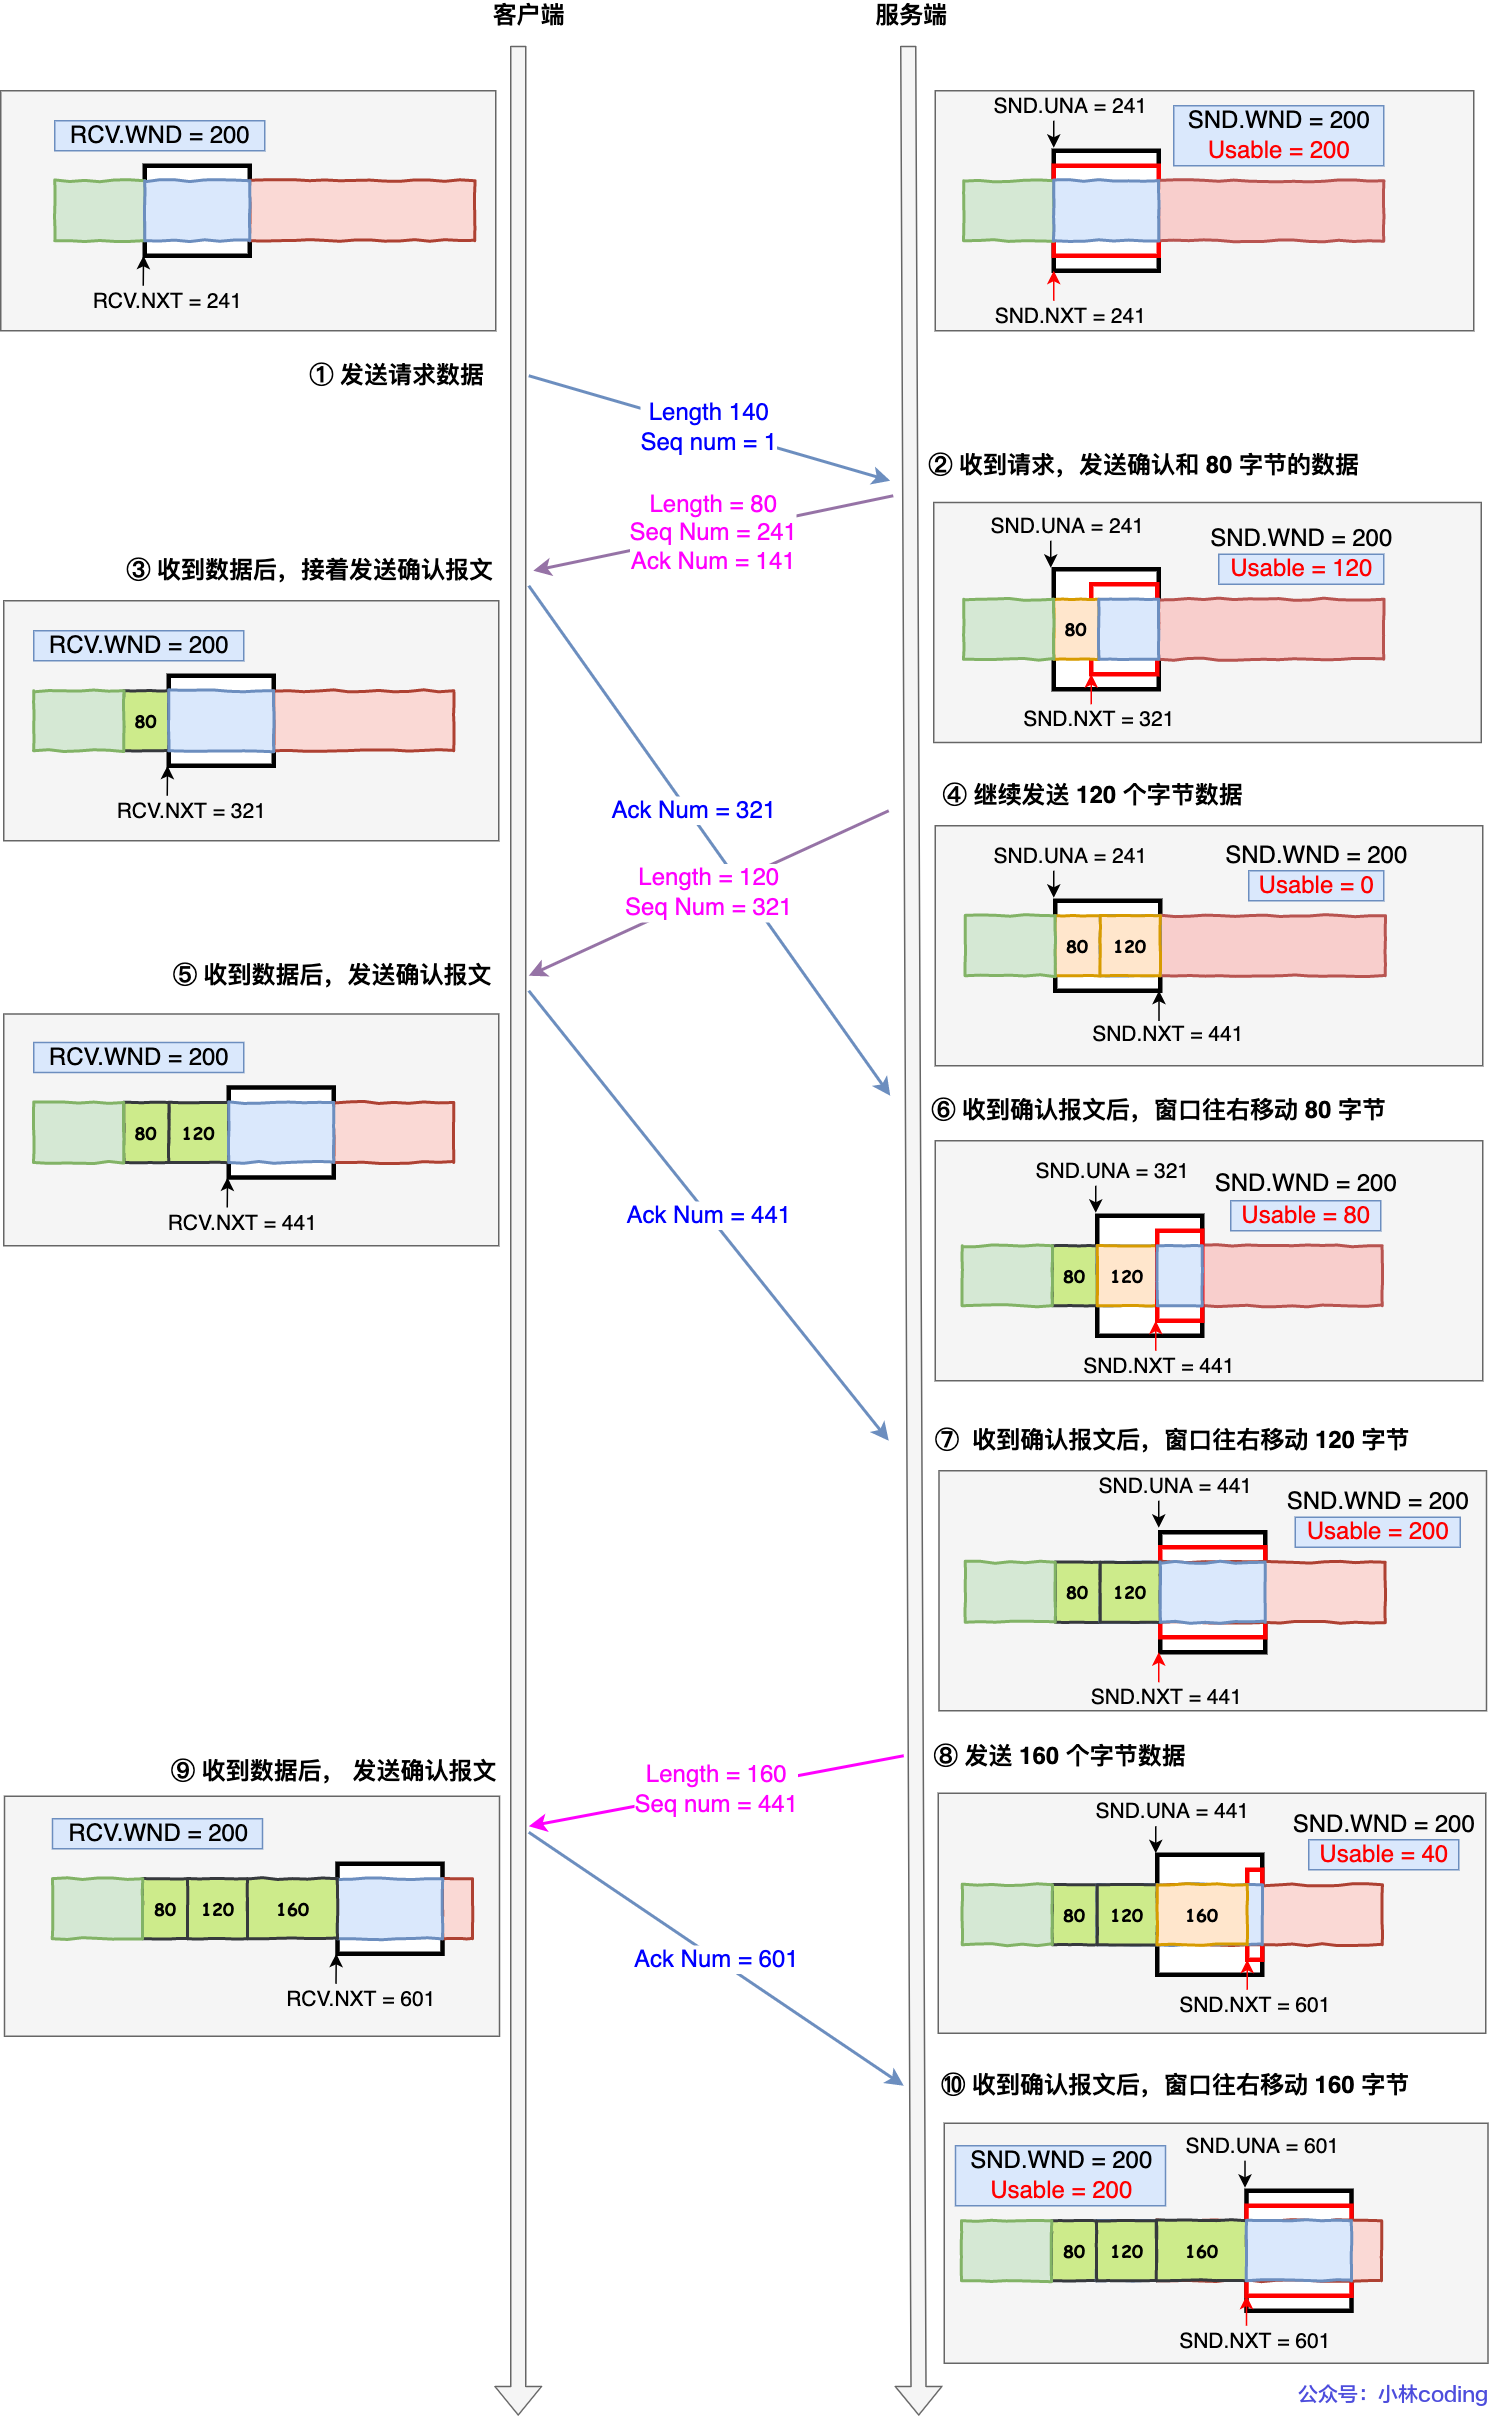
- 客户端向服务端发送请求数据报文。
- 服务端收到请求报文后,发送确认报文和80字节的数据,于是可用窗口
Usable减少为 120 字节,同时SND.NXT指针页向右偏移80字节,这意味着下次发送数据的时候,序列号时321. - 客户端收到80字节数据后,于是接收窗口往右移动80字节,
RCV.NXT也就指向321,这意味着客户端期望的下一个报文的序列号时321,接着发送确认报文给服务端。 - 服务端再次发送了120字节数据,于是可用窗口耗尽为0,服务端无法再继续发送数据。
- 客户端收到120字节的数据后,于是接收窗口往右移动 120 字节,
RCV.NXT也就指向 441,接着发送确认报文给服务端。 - 服务端收到对 80 字节数据的确认报文后,
SND.UNA指针往右偏移后指向 321,于是可用窗口Usable增大到 80。 - 服务端收到对 120 字节数据的确认报文后,
SND.UNA指针往右偏移后指向 441,于是可用窗口Usable增大到 200。 - 服务端可以继续发送了,于是发送了 160 字节的数据后,
SND.NXT指向 601,于是可用窗口Usable减少到 40。 - 客户端收到 160 字节后,接收窗口往右移动了 160 字节,
RCV.NXT也就是指向了 601,接着发送确认报文给服务端。 - 服务端收到对 160 字节数据的确认报文后,发送窗口往右移动了 160 字节,于是
SND.UNA指针偏移了 160 后指向 601,可用窗口Usable也就增大至了 200。
HTTPS是如何建立连接的?
1.ClientHello
首先由客户端向服务器发起加密通信请求,也就是CLientHello请求。
在这一步,客户端主要向服务器发送以下信息:
- 客户端支持的TLS协议版本
- 客户端产生的随机数,后面用于生成会话密钥条件之一
- 客户端支持的密码套件列表
2。ServerHello
服务器收到客户端请求后,向客户端发出相应,主要内容
- 确认TLS协议版本,如果浏览器不支持,则关闭加密通信
- 服务器生产的随机数,也就是后面用于生成会话密钥的条件之一
- 确认的密码套件列表
- 服务器的数字证书
3.客户端回应
客户端收到服务器的回应之后,首先通过浏览器或者操作系统中的CA公钥,确认服务器的数字证书的真实性。
如果证书没有问题,客户端会从数字证书中取出服务器的公钥,然后使用它加密报文,向服务器发送如下信息:
- 一个随机数,会被服务器公钥加密
- 加密通信算法改变通知,表示随后信息都将用会话密钥加密通信
- 客户端握手结束通知,表示客户端的握手阶段已经结束。这一项同时把之前所有内容的发生的数据做个摘要,用来供服务端校验。
上面第一项的随机数是整个握手阶段的第三个随机数,会发给服务端,所以这个随机数客户端和服务端都是一样的。
服务器和客户端有了这三个随机数(Client Random、Server Random、pre-master key),接着就用双方协商的加密算法,各自生成本次通信的「会话秘钥」。
4.服务器的最后回应
服务器收到客户端的第三个随机数(pre-master key)之后,通过协商的加密算法,计算出本次通信的「会话秘钥」。
然后,向客户端发送最后的信息:
(1)加密通信算法改变通知,表示随后的信息都将用「会话秘钥」加密通信。
(2)服务器握手结束通知,表示服务器的握手阶段已经结束。这一项同时把之前所有内容的发生的数据做个摘要,用来供客户端校验。
至此,整个 TLS 的握手阶段全部结束。接下来,客户端与服务器进入加密通信,就完全是使用普通的 HTTP 协议,只不过用「会话秘钥」加密内容。
Redis
zset底层原理
Zset 类型的底层数据结构是由压缩列表或跳表实现的:
- 如果有序集合的元素个数小于
128个,并且每个元素的值小于64字节时,Redis 会使用压缩列表作为 Zset 类型的底层数据结构; - 如果有序集合的元素不满足上面的条件,Redis 会使用跳表作为 Zset 类型的底层数据结构;
在 Redis 7.0 中,压缩列表数据结构已经废弃了,交由 listpack 数据结构来实现了。
算法
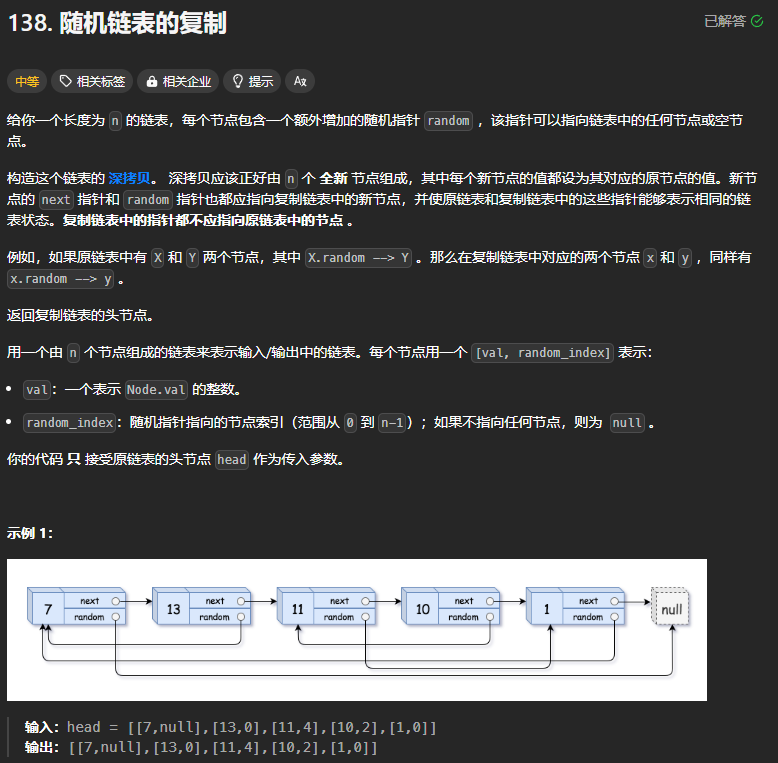
哈希表实现:
用哈希表存储每个链表节点 然后再串联next和random
1 | |
明天实现一下在节点后面添加新的节点再脱离一下